

Catalog · How the catalog works
AvoTensor

AvoTensor - a machine learning framework for the Polish language Avocado
- ★ 3 on GitHub
Anyone may press Interesting, signed in or not. It helps others find this project.
README
AvoTensor
AvoTensor to autorski, eksperymentalny framework sztucznej inteligencji, stworzony od podstaw dla ekosystemu Avocado. Został zaprojektowany z myślą o budowie, trenowaniu i uruchamianiu małych, wyspecjalizowanych i w pełni lokalnych modeli językowych (SLM - Small Language Models).
Projekt nie stanowi konkurencji dla komercyjnych gigantów ani potężnych bibliotek takich jak PyTorch czy TensorFlow. AvoTensor obiera inny kierunek: prywatność, pełna kontrola niskopoziomowa, działanie w środowisku offline (bez chmury i API) oraz integracja z aplikacjami ekosystemu Avocado.
🚀 Główne cechy frameworka
AvoTensor posiada już w pełni funkcjonalną bazę do tworzenia architektur opartych na transformatorach:
- Własny silnik tensorowy: Pełna kontrola nad formatem wag, alokacją pamięci i obliczeniami.
- Warstwy i mechanizmy sieci neuronowych:
- Warstwy liniowe (Linear)
- Osadzanie (Embeddings) i Positional Encoding
- Multi-Head Attention
- TransformerBlock
- LayerNorm & FeedForward
-
Trening i optymalizacja:
- Własna tokenizacja tekstu
- Funkcja straty CrossEntropyLoss
- Optymalizator Adam
- Pełny proces trenowania modeli językowych i generowania tekstu
-
Wielowątkowość i akceleracja sprzętowa:
- Zaawansowana obsługa wielowątkowego mnożenia macierzy przez MTProcs (zoptymalizowane pod wielordzeniowe procesory CPU, np. 24 wątki na Ryzen 9 3900X).
- Wsparcie dla GPU (OpenCL): Możliwość trenowania modeli na kartach graficznych AMD i NVIDIA, co znacząco redukuje czas obliczeń.
🛠️ Środowisko i Kompilacja
Kod frameworka AvoTensor można swobodnie skompilować przy użyciu środowiska programistycznego Lazarus.
📥 Pobierz Lazarus IDE: https://www.lazarus-ide.org/
🎯 Wizja i kierunek (Zalety)
- Pełna kontrola nad architekturą (Brak "czarnych skrzynek") - System jest pisany od podstaw, co gwarantuje dogłębne zrozumienie działania tokenizera, modelu, funkcji straty i optymalizatora.
- Lokalność i absolutna prywatność - Modele działają lokalnie (komputery klasy PC, mini PC, docelowo systemy typu Raspberry Pi). Dane nigdy nie opuszczają urządzenia.
- Niskopoziomowa kontrola - Bezpośredni dostęp do zarządzania wątkami, optymalizacji CPU/GPU i formatu zapisu wag pozwala na stworzenie własnego, dedykowanego środowiska uruchomieniowego (runtime).
- Potencjał Edge AI - Idealne rozwiązanie dla systemów automatyki, IoT, narzędzi offline oraz przedsiębiorstw wymagających przetwarzania danych na miejscu (on-premise).
- Integracja z ekosystemem Avocado - Docelowa ścisła współpraca z narzędziami takimi jak Avoraiser, Avorender czy AvocadoNet w celu tworzenia hybrydowych aplikacji AI.
⚠️ Ograniczenia i status projektu
Należy mieć na uwadze, że AvoTensor jest w fazie intensywnego rozwoju:
- To nie jest PyTorch: Brakuje tu potężnego ekosystemu, autogradu i gotowych operatorów. Większość elementów tworzona i stabilizowana jest od zera.
- Brak wsparcia dla CUDA: Akceleracja GPU opiera się obecnie na OpenCL. Nie zastępuje to dedykowanych bibliotek typu cuBLAS.
- Przeznaczenie do małych modeli: Framework jest zoptymalizowany pod parametry rzędu kilku-kilkunastu milionów, a nie miliardów (jak w przypadku LLM).
- Zarządzanie manualne: Wymagana jest rygorystyczna kontrola kształtów tensorów, stabilności numerycznej (ochrona przed NaN/Inf) oraz ręczne profilowanie zużycia pamięci.
Porównanie rynkowe
- PyTorch / TensorFlow: Dojrzałe, produkcyjne, potężne środowiska do badań.
- Ollama / LM Studio: Narzędzia do uruchamiania (inferencji) gotowych dużych modeli, nie do budowy frameworków.
- TinyML: Środowiska na mikrokontrolery o drastycznie ograniczonych zasobach.
- AvoTensor: Eksperymentalny, autorski silnik skupiony na edukacji, bezpieczeństwie danych, działaniu offline i integracji z konkretnym ekosystemem (Avocado).
📊 Wyniki testów i wydajność
Test Akceleracji: CPU vs GPU (OpenCL)
Trening modelu (617 tys. parametrów, 20 epok, słownik 860 tokenów):
- CPU (Ryzen 9 3900X, 24 wątki): 303 minuty (~5h)
- GPU (Radeon RX 5700XT, OpenCL): 109 minut (~1h 49m)
- Rezultat: Przyspieszenie rzędu 2.8x na GPU.
Test dziedzinowy (Dokumentacja Avocado)
Trening dedykowanego modelu na materiałach związanych z językiem Avocado:
- Architektura: ~2.75 mln parametrów
- Dane: 65 029 tokenów (słownik: 9 184 tokenów)
- Trening: 50 epok (50 800 kroków), czas: 480 minut (GPU + 24 wątki CPU)
- Wynik: Pomyślne zakończenie treningu z ostateczną stratą (Total Loss) na poziomie 0.0346.
🏗️ Architektura i Konfiguracja (MakeConfig)
AvoTensor pozwala na precyzyjne dostosowanie parametrów sieci. Zalecana "wąska, ale głęboka" architektura (zapobiegająca wąskim gardłom pamięci RAM na CPU):
Config := MakeConfig(VocabSize, 512, 8, 6, SeqLen);
- VocabSize: Rozmiar słownika (liczba unikalnych tokenów/słów generowanych przez model).
- EmbDim (512): Wymiar osadzeń. Określa "grubość" modelu i precyzję wektora reprezentującego pojedynczy token.
- NumHeads (8): Liczba głów mechanizmu uwagi (Multi-Head Attention). W tym wypadku 512 cech dzielone jest na 8 równoległych procesów analizujących różne zależności w tekście.
- NumLayers (6): Głębokość sieci. Liczba powtórzeń bloku transformatora pozwalająca modelowi na budowanie bardziej abstrakcyjnych powiązań.
- SeqLen (256): Rozmiar okna kontekstu. Maksymalna liczba tokenów "wstecz", na które model może analizować przy przewidywaniu kolejnego słowa.
💻 Aplikacja: Praca z modelami AI w AvoTensor
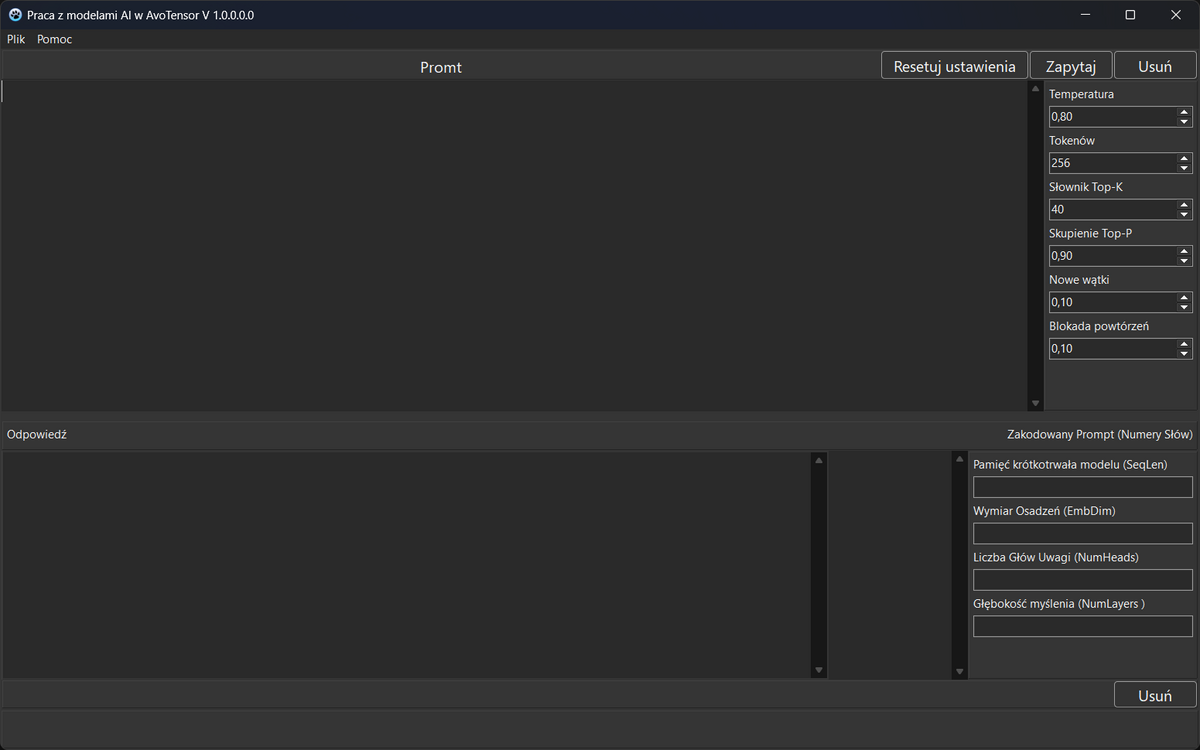
W ramach projektu powstała dedykowana aplikacja desktopowa stanowiąca graficzny interfejs (GUI) do inferencji modeli. Służy ona do testowania i demonstracji działania lokalnych modeli wytrenowanych w AvoTensor.
Główne funkcje aplikacji:
- Ładowanie wyuczonych wag z autorskiego formatu .avomodel.
- Pełna obsługa tokenizera i słownika przypisanego do modelu.
- Konfigurowalna generacja tekstu:
- Regulacja parametru Temperature (kreatywność odpowiedzi).
- Filtrowanie Top-K i Top-P.
- Kary za powtórzenia (Repetition Penalty).
- Definiowanie limitu generowanych tokenów.
- Podgląd promptu w postaci surowych wektorów (numerów tokenów).
- Odczyt i wyświetlanie hiperparametrów załadowanej architektury (SeqLen, EmbDim, NumHeads, NumLayers).
Aplikacja stanowi idealne środowisko do weryfikacji modeli dziedzinowych (np. uczonych na dokumentacji kodu) bez konieczności pisania skryptów testowych.
📥 Pobierz program: Praca z modelami AI - SourceForge
Pobierz program:
AvoTensor jest rozwijany jako narzędzie do prywatnej, lokalnej automatyzacji, umożliwiające budowanie własnego AI bezpośrednio na sprzęcie użytkownika.