

LCL Unicode Support/zh TW: what changed
Revision 2 to 3. Removed lines have a minus sign; added lines have a plus sign.
| Old | New | Line | |
|---|---|---|---|
| 1 | 1 | ## 介紹 | |
| 2 | 2 | ||
| 3 | 3 | Lazarus對Unicode的支援還需要進一步開發,尤其是在Windows平台上。以下提供一些基本的資訊,讓想要加強Lazarus對Unicode支援的人參考,如果您發現這些資訊有誤、不足或過時了,請您不吝修正、補充或更新它,謝謝。 | |
| 4 | 4 | ||
| 5 | 5 | 如果您已經初步了解Unicode的標準,且您已經在Delphi上面有使用過WideString這個型別來撰寫程式,會有助於您理解Lazarus對Unicode支援的加強工作。如果您使用過非Latin編碼的字元集來撰寫腳本語言,也會有些幫助的。 | |
| 6 | 6 | ||
| 7 | 7 | 請注意: 實作的細節部分目前還在討論中,這部分的文件隨時都有可能更新。 | |
| 8 | 8 | ||
| 9 | 9 | ## 程式實作規範 | |
| 10 | 10 | ||
| 11 | 11 | ### 需求 | |
| 12 | 12 | ||
| 13 | 13 | Lazarus的精神是”程式寫一次,就能在各種平台上『編譯』” (JAVA的精神則是『程式寫一次,就能在各種平台上『執行』)。根據Lazarus的精神,表示在理想狀態下,一個支援Unicode的應用程式,應該只有一份能夠支援Unicode的程式碼,而不用為各種不同的語系作不同的原始碼,或者資源檔。更不用在程式碼裡面使用條件定義(IFDEF)為不同的作業系統/不同語系作編譯的定義。 | |
| 14 | 14 | ||
| 15 | 15 | 在LCL的 “interface”宣告部分,已經可以支援各種相容於Unicode的作業系統,讓程式人員可以不用去管每個系統上面對Unicode要怎麼處理的繁瑣細節。 | |
| 16 | 16 | ||
| 17 | 17 | 而Lazarus本身需要注意的,則是在Lazarus內部用來溝通的字串 (例如應用程式跟LCL,以及 LCL跟視窗元件之間),都是透過Pascal的原始string (string裡的每個字元都是1個Byte,而Unicode是多個Byte的字元集)。因此,邏輯上來說,Lazarus的程式碼就必須以[[UTF-8]]編碼來儲存,才能保留住所有Unicode的相關資訊。 | |
| 18 | 18 | ||
| 19 | 19 | ### 和Unicode進行整合 | |
| 20 | 20 | ||
| 21 | 21 | 目前絕大多數版本的Lazarus使用的是Ansi編碼,因為這是Gtk1預設的編碼法,也是Win32目前的預設編碼法,Windows 2000以後的Windows作業系統雖然都已經能夠相容於Unicode,但預設的編碼法仍然是Ansi,這個情形在不久的未來恐怕會有所改變,所有的視窗元件都會支援UTF-8,而所有的應用程式在傳遞資料給介面時,也都需要先轉換成 UTF-8了,當然,這得依賴各種IDE的作者在元件檢視器裡面更改程式碼才能作到。 | |
| 22 | 22 | ||
| 23 | 23 | 當我們在還沒完全支援Unicode的視窗元件上面開發程式的時候(例如 Gtk 2, Qt, WinCE, 或許也包含將會出現的Win32U),我們是使用IDE來對比較穩定的視窗元件進行編譯的 (例如Gtk跟Win32)。為了保持一致性(例如以ISO字元編碼把資料傳遞給UTF-8的視窗元件),讓IDE跟視窗元件使用一致的編碼是必要的,這也就表示在能夠製作出Unicode的應用程式前,我們將會需要一個穩定的UTF-8的IDE程式。 | |
| 24 | 24 | ||
| 25 | 25 | 目前我們有幾組不同的視覺元件,分別使用以下的編碼法: | |
| 26 | 26 | ||
| 27 | 27 | - 使用ANSI編碼法: win32跟 gtk (1) 介面 | |
| 28 | 28 | ||
| 29 | 29 | - 使用 UTF-8 編碼法: gtk (1), gtk2, qt, fpGUI, carbin | |
| 30 | 30 | ||
| 31 | 31 | - 目前還使用ANSI編碼,但需要升級到UTF-8編碼: win32, wince | |
| 32 | 32 | ||
| 33 | 33 | 請留意,gtk 1同時屬於ANSI跟UTF-8的陣營喔,這是因為gtk 1的編碼法,是可以從Gtk 1的環境變數裡面加以控制的。 | |
| 34 | 34 | ||
| 35 | 35 | 正如目前的Lazarus一樣,大多數的應用程式目前都能正常運作,如果用win32, wince或gtk介面重新編譯,就得面對要編譯其他視窗元件時,使用不同編碼的窘境了。而支援UTF-8的應用程式在重新編譯給使用Unicode的視窗元件時,就沒有這個問題。 | |
| 36 | 36 | ||
| 37 | 37 | 很重要的一點是,當您要編譯程式時,請記得使用跟您要編譯的程式相同編碼法的IDE來作。這是因為IDE在進行程式編譯的時候,IDE是用它被編譯時的編碼法來產生LFM跟LRS檔案的,而不是我們想要甚麼編碼法,它就能自動切換過去的,這點非常重要,不可不察。 | |
| 38 | 38 | ||
| 39 | 39 | ## 發展路線 | |
| 40 | 40 | ||
| 41 | 41 | 目前我們已經有了準則,所以該建立發展路線,並加以實現的時候了。 為此,我們建立了以下的計畫,我們的計畫是把工作分為兩個群組,一個是主要工作,另一個是次要工作。 | |
| 42 | 42 | ||
| 43 | 43 | 所有的主要工作都必須在我們宣布Lazarus支援之前完成,這些工作會被當成我們工作中的主要確認部分。 | |
| 44 | 44 | ||
| 45 | 45 | 次要工作則是該作,但沒有自願者想作,或者為這些工作定出範圍之前不會進行的。 | |
| 46 | 46 | ||
| 47 | 47 | ### 主要工作 | |
| 48 | 48 | ||
| 49 | 49 | **使 Win32 視窗元件支援 UTF-8** | |
| 50 | 50 | ||
| 51 | 51 | 備註: 在這個步驟中,我們會將所有的32 bits Windows作業系統同時當成目標,這階段中所有寫出來的程式碼都會在目前的win32介面中用IFDEF來區隔,以避免在主要的介面中產生問題。在過渡時期結束之後,IFDEF的宣告就會全部移除,只留下Unicode的支援。 | |
| 52 | 52 | ||
| 53 | 53 | 狀態: 部分已完成。 | |
| 54 | 54 | ||
| 55 | 55 | **更新 Gtk 2 的鍵盤程式碼,使得UTF-8能夠被支援** | |
| 56 | 56 | ||
| 57 | 57 | 備註: | |
| 58 | 58 | ||
| 59 | 59 | 狀態: 幾乎已完成。部分gtk2預先定義的功能,讓使用者自訂的部分還沒有完成,但我不知道哪幾個語系會使用者這些功能。 | |
| 60 | 60 | ||
| 61 | 61 | **讓Lazarus IDE能正確的跟Win32 Unicode視窗元件運作並支援UTF-8** | |
| 62 | 62 | ||
| 63 | 63 | 備註: | |
| 64 | 64 | ||
| 65 | 65 | 狀態: 已完成。除了字元對應表,目前字元對應表仍舊只顯示255個字元,但反正目前所有的OS都已經提供了很好的Unicode字元對應表,所以這應該也不是那麼重要了。 | |
| 66 | 66 | ||
| 67 | 67 | **讓Lazarus IDE能正確的跟Gtk 2視窗元件運作並支援UTF-8** | |
| 68 | 68 | ||
| 69 | 69 | 備註: | |
| 70 | 70 | ||
| 71 | 71 | 狀態: 已完成。還有些gtk2介面的問題,但這已經跟UTF-8無關了 | |
| 72 | 72 | ||
| 73 | 73 | ### 次要工作 | |
| 74 | 74 | ||
| 75 | 75 | **升級Windows CE的視窗元件,使它能使用UTF-8** | |
| 76 | 76 | ||
| 77 | 77 | 備註: 字串轉換的程式碼已經集中在winceproc.pp這個檔案裡面,還需要許多測試。 | |
| 78 | 78 | ||
| 79 | 79 | 狀態: 尚未開始 | |
| 80 | 80 | ||
| 81 | 81 | **升級Gtk 1鍵盤功能,讓它能使用UTF-8** | |
| 82 | 82 | ||
| 83 | 83 | 備註: | |
| 84 | 84 | ||
| 85 | 85 | 狀態: 尚未開始 | |
| 86 | 86 | ||
| 87 | 87 | **完成synedit對由右到左(RTL)的文字顯示的支援** | |
| 88 | 88 | ||
| 89 | 89 | 備註: RTL是指由右到左的輸入法,例如阿拉伯文。 | |
| 90 | 90 | ||
| 91 | 91 | 狀態: 尚未開始 | |
| 92 | 92 | ||
| 93 | 93 | ## Unicode 須知 | |
| 94 | 94 | ||
| 95 | 95 | Unicode的標準是將整數的0到10FFFF(十六進位)對應為文字。每一個對應關係,稱為一個個的編碼點(code point)。換句話說,Unicode的字元原則上是定義了U+000000到U+10FFFF個編碼點(用十進位來算,是 0到1,114,111)。 | |
| 96 | 96 | ||
| 97 | 97 | 要表現Unicode的編碼點的位元順序,一共有三種方法。這些方法被稱為Unicode轉換格式(Unicode transformation formats)分別是: UTF-8, UTF-16和UTF-32。這三種格式之間是可以相互轉換的,以下是這些格式的基本說明: | |
| 98 | 98 | ||
| 99 | 99 | (原文) | |
| 100 | 100 | ||
| 101 | - | ||
| 102 | - | ||
| 103 | - | ||
| 104 | - | ||
| 105 | - | ||
| 106 | - | ||
| 101 | + | ``` pascal | |
| 102 | + | UTF-8 UTF-16 UTF-32 | |
| 103 | + | Smallest code point [hex] 000000 000000 000000 | |
| 104 | + | Largest code point [hex] 10FFFF 10FFFF 10FFFF | |
| 105 | + | Code unit size [bits] 8 16 32 | |
| 106 | + | Minimal bytes/character 1 2 4 | |
| 107 | + | Maximal bytes/character 4 4 4 | |
| 108 | + | ``` | |
| 107 | 109 | ||
| 108 | 110 | (中文) | |
| 109 | 111 | ||
| 110 | - | ||
| 111 | - | ||
| 112 | - | ||
| 113 | - | ||
| 114 | - | ||
| 115 | - | ||
| 112 | + | ```text | |
| 113 | + | UTF-8 UTF-16 UTF-32 | |
| 114 | + | 最小編碼點 [十六進位] 000000 000000 000000 | |
| 115 | + | 最大編碼點 [十六進位] 10FFFF 10FFFF 10FFFF | |
| 116 | + | 單位編碼Size [bits] 8 16 32 | |
| 117 | + | 佔用位元組量(最少) 1 2 4 | |
| 118 | + | 佔用位元組量(最多) 4 4 4 | |
| 119 | + | ``` | |
| 116 | 120 | ||
| 117 | 121 | **UTF-8** 包含幾個重要且有用的屬性:它是以Byte的順序進行解譯的,所以沒有Hi-Byte跟Lo-Byte的差別(其它雙位元組的多國語系字元編碼都有這樣的問題)。 Unicode對字元的定義中,從U+0000到U+007F (ASCII)正好就是直接對應到00h到7Fh,可以跟ASCII直接相容。這意味著使用7-bit ASCII字元的檔案或字串,在傳遞ASCII跟UTF-8的時候,是完全相同的編碼方式。而編碼點大於U+007F的字元則是依照位元組的順序進行編碼,正好每兩個Byte就能代表一個Unicode的字元。因此不會出現一個字元的Byte使用或涵蓋到別的字元的資料,也使得製作子字串的搜尋功能簡單多了。代表非ASCII字元的位元組中,第一個Byte的內容一定必須在C0h到FDh之間,並且說明這個Unicode字元是使用了幾個Bytes來記錄的。所有在第一個Byte之後的資料,都一定落在80h到BFh之間,這樣的規則也使得自動化與重新修復文件的程序變得更簡單。 | |
| 118 | 122 | ||
| 119 | 123 | **UTF-16**則包含了以下重要的屬性: 它只使用16 bit的Word對從U+0000到U+d7ff這些字元進行編碼,而其餘的Unicode字元編碼,則會使用成對的16-bit Words。 | |
| 120 | 124 | ||
| 121 | 125 | 最後,任何一個Unicode字元都可以用32-bit為單位的資料來表現,就稱為**UTF-32**. | |
| 122 | 126 | ||
| 123 | 127 | 如果您需要更多的資料,請參閱: [Unicode FAQ - Basic questions](http://www.unicode.org/faq/basic_q.html), [Unicode FAQ - UTF-8, UTF-16, UTF-32 & BOM](http://www.unicode.org/faq/utf_bom.html), [Wikipedia: UTF-8](http://en.wikipedia.org/wiki/UTF-8) [1](http://en.wikipedia.org/wiki/ISO-8859) | |
| 124 | 128 | ||
| 125 | 129 | ## Lazarus 元件庫架構須知 | |
| 126 | 130 | ||
| 127 | 131 | LCL包含了兩個部分: | |
| 128 | 132 | ||
| 129 | 133 | 1. 跟編譯目標作業平台無關的部分,這部分是使用跟Delphi VCL相似的類別架構來實現的。 | |
| 130 | 134 | 2. "Interfaces" – 使用各編譯目標作業平台相關的API來實現的。 | |
| 131 | 135 | ||
| 132 | 136 | 介於兩個部分之間的溝通,則是透過TWidgetset這個抽象類別來達成的,每個Widgetset的實現都是從TWidgetset這個父類別衍生而來的。 | |
| 133 | 137 | ||
| 134 | 138 | GTK 1的視覺元件是最舊的版本。在該版本的視覺元件當中,字元的編碼是以”LANG”這個環境變數來決定的,通常是” ISO-8859-n”這一類的單位元字串編碼。近幾年內建GTK 1的系統,已經開始把預設字元編碼設定為UTF-8了,例如2007年的Mandriva就是一例。在Lazarus的Gtk 1介面中,還少了支援UTF-8的鍵盤控制功能,這是個大問題,如果不解決的話,Lazarus將無法真正支援跨平台Unicode相容的目標。 | |
| 135 | 139 | ||
| 136 | 140 | Gtk2的視覺元件只能使用UTF-8編碼,並且完全支援UTF-8的各項要求。 | |
| 137 | 141 | ||
| 138 | 142 | Win32介面在預設時,使用的是ANSI編碼的視覺元件,目前已經開始進行修改,讓它能夠支援UTF-8,但因為還沒完成,所以預設是不使用UTF-8的,也因此目前在Win32介面的視覺元件上,暫時還無法使用Unicode。 | |
| 139 | 143 | ||
| 140 | 144 | Qt介面已經完成了支援UTF-8的準備,在Qt介面中,原生的字元編碼是使用UTF-16,但Lazarus的Qt介面會把UTF-8轉換為UTF-16,所以在支援上沒有問題。 | |
| 141 | 145 | ||
| 142 | 146 | Windows CE只支援UTF-16的字元編碼,但Lazarus的Windows CE介面則是在呼叫Windows API之前,先把ISO字元轉換為UTF-16編碼,所以這部分還算容易修改,就像目前我們把所有的字元轉換函式集中放在winceproc.pp裡面一樣。 | |
| 143 | 147 | ||
| 144 | 148 | 如果您需要更多資訊,請參考: [[LCL Internals|LCL內部資訊]] | |
| 145 | 149 | ||
| 146 | 150 | ## 讓win32介面相容於Unicode | |
| 147 | 151 | ||
| 148 | 152 | ### 編譯能使用Unicode的LCL-Win32函式庫 | |
| 149 | 153 | ||
| 150 | 154 | 要使Windows版的LCL函式庫能使用Unicode,您得先到Lazarus的選單中"Tools" --\> "Configure Build Lazarus"進行設定。 | |
| 151 | 155 | ||
| 152 | 156 | 請在"Options"的欄位中加上” –dWindowsUnicodeSupport”這個設定值,並把所有的建置對象都選為NONE,只留下LCL的設定選項是Clean+Build,然後再設定win32為要建置的視覺元件(widgetset),按下”Build”按鍵,即可將LCL重新編譯為與Unicode相容的版本了。 | |
| 153 | 157 | ||
| 154 | 158 | 完成後,您就可以把您已完成的應用程式重新編譯,編譯完成後,它們也都能夠支援Unicode了。 | |
| 155 | 159 | ||
| 156 | 160 | ### 準則 | |
| 157 | 161 | ||
| 158 | 162 | 首先,也是最重要的,所有為Win32介面進行的增補工作,都必須被包在 IFDEF WindowsUnicodeSupport這個編譯條件式裡面,以避免破壞了現有的ANSI介面,等到Unicode相容修正的專案穩定之後,這些IFDEF的編譯條件式就會一起被拿掉,而只留下Unicode相容的程式碼。在目前這個時間點上,所有現存使用ANSI標準編碼的程式,都還得由程式設計人員將之升級,才能與Unicode相容。 | |
| 159 | 163 | ||
| 160 | 164 | Windows平台 \<= Win9x只支援ISO系列的字元編碼標準,並只有部分功能支援Unicode。Windows系列的平台,是從Windows NT跟Windows CE開始完全支援Unicode的(也同時還支援ISO系列編碼,算是雙軌並行),Win9x跟NT的API裡面,每一個功能都同時提供了兩個函式,一個是ANSI編碼的(函式名稱結尾都會加個A),另一個則是Unicode相容的(函式名稱結尾則是會加個W)。 | |
| 161 | 165 | ||
| 162 | 166 | - W的函式中如果需要傳遞字串參數,接受的字串必須是WideString,例如UTF-16字串,而Windows CE只使用 *W的API。 | |
| 163 | 167 | ||
| 164 | 168 | #### 在Windows 9x上面,Unicode系列函式的呈現 | |
| 165 | 169 | ||
| 166 | 170 | 有些Unicode系列的API也會呈現在Windows 9x平台上,以下就是這些Unicode系列API的列表: <http://msdn.microsoft.com/library/default.asp?url=/library/en-us/mslu/winprog/other_existing_unicode_support.asp> | |
| 167 | 171 | ||
| 168 | 172 | 轉換範例: | |
| 169 | 173 | ||
| 170 | 174 | GetTextExtentPoint32(hdcNewBitmap, LPSTR(ButtonCaption), | |
| 171 | 175 | Length(ButtonCaption), TextSize); | |
| 172 | 176 | ||
| 173 | 177 | 要改為: | |
| 174 | 178 | ||
| 175 | 179 | {$ifdef WindowsUnicodeSupport} | |
| 176 | 180 | GetTextExtentPoint32W(hdcNewBitmap, PWideChar(Utf8Decode(ButtonCaption)), Length(WideCaption), TextSize); | |
| 177 | 181 | {$else} | |
| 178 | 182 | GetTextExtentPoint32(hdcNewBitmap, LPSTR(ButtonCaption), Length(ButtonCaption), TextSize); | |
| 179 | 183 | {$endif} | |
| 180 | 184 | ||
| 181 | 185 | #### 需要轉換ANSI跟Unicode版本的函式 | |
| 182 | 186 | ||
| 183 | 187 | 第一個簡單的轉換範例: | |
| 184 | 188 | ||
| 185 | 189 | function TGDIWindow.GetTitle: String; | |
| 186 | 190 | var | |
| 187 | 191 | l: Integer; | |
| 188 | 192 | begin | |
| 189 | 193 | l := Windows.GetWindowTextLength(Handle); | |
| 190 | 194 | SetLength(Result, l); | |
| 191 | 195 | Windows.GetWindowText(Handle, @Result[1], l); | |
| 192 | 196 | end; | |
| 193 | 197 | ||
| 194 | 198 | 必須轉換為: | |
| 195 | 199 | ||
| 196 | 200 | function TGDIWindow.GetTitle: String; | |
| 197 | 201 | var | |
| 198 | 202 | l: Integer; | |
| 199 | 203 | AnsiBuffer: string; | |
| 200 | 204 | WideBuffer: WideString; | |
| 201 | 205 | begin | |
| 202 | 206 | ||
| 203 | 207 | {$ifdef WindowsUnicodeSupport} | |
| 204 | 208 | ||
| 205 | 209 | if UnicodeEnabledOS then | |
| 206 | 210 | begin | |
| 207 | 211 | l := Windows.GetWindowTextLengthW(Handle); | |
| 208 | 212 | SetLength(WideBuffer, l); | |
| 209 | 213 | l := Windows.GetWindowTextW(Handle, @WideBuffer[1], l); | |
| 210 | 214 | SetLength(WideBuffer, l); | |
| 211 | 215 | Result := Utf8Encode(WideBuffer); | |
| 212 | 216 | end | |
| 213 | 217 | else | |
| 214 | 218 | begin | |
| 215 | 219 | l := Windows.GetWindowTextLength(Handle); | |
| 216 | 220 | SetLength(AnsiBuffer, l); | |
| 217 | 221 | l := Windows.GetWindowText(Handle, @AnsiBuffer[1], l); | |
| 218 | 222 | SetLength(AnsiBuffer, l); | |
| 219 | 223 | Result := AnsiToUtf8(AnsiBuffer); | |
| 220 | 224 | end; | |
| 221 | 225 | ||
| 222 | 226 | {$else} | |
| 223 | 227 | ||
| 224 | 228 | l := Windows.GetWindowTextLength(Handle); | |
| 225 | 229 | SetLength(Result, l); | |
| 226 | 230 | Windows.GetWindowText(Handle, @Result[1], l); | |
| 227 | 231 | ||
| 228 | 232 | {$endif} | |
| 229 | 233 | ||
| 230 | 234 | end; | |
| 231 | 235 | ||
| 232 | 236 | ### Roadmap 未來發展計畫 | |
| 233 | 237 | ||
| 234 | 238 | #### 在相容於Unicode的延伸計畫中,甚麼是必須要作的: | |
| 235 | 239 | ||
| 236 | 240 | - TForm, TButton, TLabel | |
| 237 | 241 | - 大多數的控制項 | |
| 238 | 242 | - 選單元件 | |
| 239 | 243 | - LCLIntf.ExtTextOut 以及大多數和字串相關的WinAPI | |
| 240 | 244 | - 以TStrings為基礎的控制項. 例如: TComboBox, TListBox等等 | |
| 241 | 245 | - SynEdit 顯示與輸入UTF-8字元必須正確 | |
| 242 | 246 | ||
| 243 | 247 | #### 要支援Unicode的話,目前已知的問題: | |
| 244 | 248 | ||
| 245 | 249 | - SynEdit不支援由右到左顯示的字元 | |
| 246 | 250 | - 在編輯器上面雙擊非ANSI編碼的字元時,被雙擊的字不會被選取,反而是被雙擊的字左方的其他字會被選取起來 | |
| 247 | 251 | - 複製貼上Unicode字元的時候,如果當時的視窗環境不是使用Unicode為編碼字元的話,複製貼上的動作會不正確 | |
| 248 | 252 | - MessageBox上面的按鍵文字就算已經翻譯完成,也無法正確顯示Unicode字元。這已經在IDE上面測試過了,不過也可能單純的就只是IDE的問題而已。 | |
| 249 | 253 | - 在Project option設定應用程式Title的時候,如果設定為Unicode的字串,顯示可能不正確。 | |
| 250 | 254 | ||
| 251 | 255 | 在重新檢視程式碼之後,下列的問題需要進行測試,因為這些程式碼似乎無法相容於Unicode: | |
| 252 | 256 | ||
| 253 | 257 | - 在PrepareCreateWindow (Win32WSControls這個單元檔裡面) 的這行程式: | |
| 254 | 258 | ||
| 255 | - | ||
| 259 | + | ``` pascal | |
| 260 | + | StrCaption := PChar(AWinControl.Caption); | |
| 261 | + | ``` | |
| 256 | 262 | ||
| 257 | 263 | - (還有一些問題是沒有被確認的,如果經過確認的話,就會一道列在上述的清單裡面) | |
| 258 | 264 | ||
| 259 | 265 | #### 需要檢查的Unit檔的清單: | |
| 260 | 266 | ||
| 261 | 267 | - "win32callback.inc" | |
| 262 | 268 | - "win32def.pp" | |
| 263 | 269 | - "win32int.pp" | |
| 264 | 270 | - "win32lclintf.inc" | |
| 265 | 271 | - "win32lclintfh.inc" | |
| 266 | 272 | - "win32listsl.inc" | |
| 267 | 273 | - "win32listslh.inc" | |
| 268 | 274 | - "win32memostrings.inc" | |
| 269 | 275 | - "win32object.inc" | |
| 270 | 276 | - "win32proc.pp" | |
| 271 | 277 | - "win32winapi.inc" | |
| 272 | 278 | - "win32winapih.inc" | |
| 273 | 279 | - "win32wsactnlist.pp" | |
| 274 | 280 | - "win32wsarrow.pp" | |
| 275 | 281 | - "win32wsbuttons.pp" | |
| 276 | 282 | - "win32wscalendar.pp" | |
| 277 | 283 | - "win32wschecklst.pp" | |
| 278 | 284 | - "win32wsclistbox.pp" | |
| 279 | 285 | - "win32wscomctrls.pp" | |
| 280 | 286 | - "win32wscontrols.pp" | |
| 281 | 287 | - "win32wscustomlistview.inc" | |
| 282 | 288 | - "win32wsdbctrls.pp" | |
| 283 | 289 | - "win32wsdbgrids.pp" | |
| 284 | 290 | - "win32wsdialogs.pp" | |
| 285 | 291 | - "win32wsdirsel.pp" - Felipe | |
| 286 | 292 | - "win32wseditbtn.pp" - Felipe | |
| 287 | 293 | - "win32wsextctrls.pp" - Felipe | |
| 288 | 294 | - "win32wsextdlgs.pp" - Felipe | |
| 289 | 295 | - "win32wsfilectrl.pp" - Felipe | |
| 290 | 296 | - "win32wsforms.pp" - Felipe | |
| 291 | 297 | - "win32wsgrids.pp" - Felipe | |
| 292 | 298 | - "win32wsimglist.pp" - Felipe | |
| 293 | 299 | - "win32wsmaskedit.pp" - Felipe | |
| 294 | 300 | - "win32wsmenus.pp" - Felipe | |
| 295 | 301 | - "win32wspairsplitter.pp" - Felipe | |
| 296 | 302 | - "win32wsspin.pp" - Felipe | |
| 297 | 303 | - "win32wsstdctrls.pp" - Felipe | |
| 298 | 304 | - "win32wstoolwin.pp" - Felipe | |
| 299 | 305 | - "winext.pas" - Felipe | |
| 300 | 306 | ||
| 301 | 307 | ### 螢幕截圖 | |
| 302 | 308 | ||
| 303 | 309 | 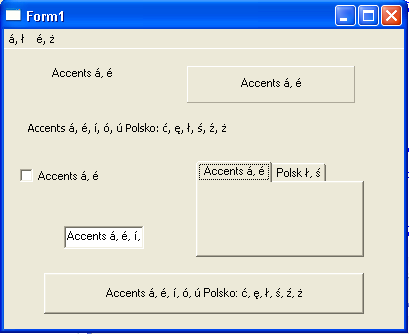 | |
| 304 | 310 | ||
| 305 | 311 | ## 額外參考 | |
| 306 | 312 | ||
| 307 | 313 | - [[UTF-8]] - Description of UTF-8 strings | |
| 308 | 314 | ||
| 309 | 315 | - 初版正體中文翻譯,由[元智大學](http://www.yzu.edu.tw/)[資訊傳播學系](http://www.infocom.yzu.edu.tw/)兼任講師[張子仁 (Dennies Chang)](mailto://dennies@ms4.hinet.net)製作。 - 2008/2/21 User:Dennies | |
| 310 | 316 | ||
| 311 | 317 | --- | |
| 312 | 318 | *From the Free Pascal wiki, page "LCL Unicode Support/zh TW", as it stood on 2008-05-19 after a change by Pengtu, out of the wiki's dump of 2024-05-26. Copyright stays with the author who wrote it, according to the old wiki's [[Licensing]] page. If you have concerns about this material, [message the admin](/wiki-contact).* | |
| 313 | 319 | Category: zh |