

LCL Unicode Support/ru: what changed
Revision 1 to 2. Removed lines have a minus sign; added lines have a plus sign.
| Old | New | Line | |
|---|---|---|---|
| 1 | 1 | ## Введение | |
| 2 | 2 | ||
| 3 | 3 | Начиная с 0.9.25 Lazarus полностью поддерживает юникод (Unicode) на всех платформах, исключая Gtk 1. На этой странице размещены инструкции для пользователей Lazarus, планы на будущее, описаны основные концепции и детали реализации. | |
| 4 | 4 | ||
| 5 | 5 | ## Инструкции для пользователей | |
| 6 | 6 | ||
| 7 | 7 | Хотя в Lazarus есть юникодные наборы виджетов, важно отметить, что не всё в юникоде. Кодировка строк и правильное преобразование между библиотеками, ожидающими разные кодировки, является ответственностью разработчика. | |
| 8 | 8 | ||
| 9 | 9 | Обычно библиотекой используется единая кодировка строк (речь о динамической библиотеке DLL или пакете Lazarus). Каждая библиотека обычно ожидает одну кодировку, которой может быть юникод (UTF-8 для Lazarus) или ANSI (что означает системную кодировку, которая может быть UTF-8 или другой). RTL и FCL в FPC версий 2.4-2.6 ожидают строки ANSI. | |
| 10 | 10 | ||
| 11 | 11 | Преобразование между юникодом и ANSI возможно при помощи функций **UTF8ToAnsi** и **AnsiToUTF8** модуля System или **UTF8ToSys** и **SysToUTF8** модуля FileUtil (Lazarus). Последние две мощнее (быстрее), но добавят к программе больше кода. | |
| 12 | 12 | ||
| 13 | 13 | ### FPC не юникодный | |
| 14 | 14 | ||
| 15 | 15 | Библиотеки Free Pascal времени исполнения (RTL) и свободных компонентов (FCL) в текущих версиях FPC (по 2.6.1) используют ANSI, поэтому требуется преобразование строк, получаемых из юникодных или переделываемых в юникодные библиотек (например, LCL). | |
| 16 | 16 | ||
| 17 | 17 | ### Преобразование между ANSI и юникодом | |
| 18 | 18 | ||
| 19 | 19 | Примеры: | |
| 20 | 20 | ||
| 21 | 21 | Допустим, нужно передать в файловую функцию из RTL строку, полученную из TEdit: | |
| 22 | 22 | ||
| 23 | 23 | ``` pascal | |
| 24 | 24 | var | |
| 25 | 25 | MyString: string; // в кодировке utf-8 | |
| 26 | 26 | begin | |
| 27 | 27 | MyString := MyTEdit.Text; | |
| 28 | 28 | SomeRTLRoutine(UTF8ToAnsi(MyString)); | |
| 29 | 29 | end; | |
| 30 | 30 | ``` | |
| 31 | 31 | ||
| 32 | 32 | И в обратную сторону: | |
| 33 | 33 | ||
| 34 | 34 | ``` pascal | |
| 35 | 35 | var | |
| 36 | 36 | MyString: string; // в кодировке ANSI | |
| 37 | 37 | begin | |
| 38 | 38 | MyString := SomeRTLRoutine; | |
| 39 | 39 | MyTEdit.Text := AnsiToUTF8(MyString); | |
| 40 | 40 | end; | |
| 41 | 41 | ``` | |
| 42 | 42 | ||
| 43 | 43 | **Важно**: UTF8ToAnsi возвратит пустую строку, если строка в UTF-8 содержит неверные символы. | |
| 44 | 44 | ||
| 45 | 45 | **Важно**: AnsiToUTF8 и UTF8ToAnsi требуют менеджера "широких" строк (widestring) в Linux, BSD и macOS. Можно воспользоваться функциями SysToUTF8 или UTF8ToSys (из модуля FileUtil) или добавить менеджер, включив cwstring одним из первых модулей в разделе uses программы. | |
| 46 | 46 | ||
| 47 | 47 | ### Строки WideString и AnsiString | |
| 48 | 48 | ||
| 49 | 49 | WideString -- это строковый тип, у которого базовый элемент данных имеет размер 2 байта. Строки этого типа почти всегда в кодировке UTF-16. См. [[Widestrings]] | |
| 50 | 50 | ||
| 51 | 51 | Обратите внимание, что при доступе к WideString как к массиву, каждый его элемент представлен 2 байтами, а символ в UTF-16 может состоять из 1 или 2 элементов, занимающих соответственно 2 или 4 байта. Поэтому при доступе к WideString как к массиву **совершенно неправильно** ожидать соответствия "один элемент -- один символ", наличие в строке 4-х байтовых символов приведёт к ошибкам. Заметьте также, что UTF-16 как и UTF-8, допускает составные (decomposed) символы. Например, символ "Á" может быть представлен как одним элементом, так и парой: "A" + изменяющий акцент. Таким образом, включающий акцентированные буквы текст в юникоде часто может быть закодирован различными способами, Lazarus и FPC не обрабатывают такие случаи автоматически. | |
| 52 | 52 | ||
| 53 | 53 | При передаче AnsiString в качестве WideString требуется преобразование кодировки. | |
| 54 | 54 | ||
| 55 | 55 | ``` pascal | |
| 56 | 56 | var | |
| 57 | 57 | w: widestring; | |
| 58 | 58 | begin | |
| 59 | 59 | w:='Über'; // неправильно, FPC преобразует системную кодовую страницу в UTF16 | |
| 60 | 60 | w:=UTF8ToUTF16('Über'); // правильно | |
| 61 | 61 | Button1.Caption:=UTF16ToUTF8(w); | |
| 62 | 62 | end; | |
| 63 | 63 | ``` | |
| 64 | 64 | ||
| 65 | 65 | ### Работа со строками и символами UTF-8 | |
| 66 | 66 | ||
| 67 | 67 | В Lazarus до версии 0.9.30 включительно функции LCL для работы с UTF-8 находились в модуле LCLProc. В Lazarus 0.9.31 и последующих они в целях совместимости по-прежнему доступны при подключении LCLProc, но сам код работы с UTF-8 находится в модуле lazutf8 пакета lazutils. | |
| 68 | 68 | ||
| 69 | 69 | Для выполнения операций над строками в UTF-8 используйте функции модуля lazutf8 вместо предоставляемых модулем SysUtils из FPC, поскольку SysUtils не готов для работы с юникодом, а lazutf8 готов. Просто замените утилиты из SysUtils на эквивалентные из lazutf8, имеющие те же имена с префиксом UTF-8. | |
| 70 | 70 | ||
| 71 | 71 | Учтите также, что перебор символов как элементов строки-массива не подходит для юникода. Эта особенность присуща не только UTF-8, юникод не предполагает фиксированный размер каждого символа. Возможны два основных способа перебора символов строки в кодировке UTF-8: | |
| 72 | 72 | ||
| 73 | 73 | - побайтовый -- подходит для поиска подстроки или поиска ASCII символов в строке UTF-8, например, при разборе файлов XML. | |
| 74 | 74 | - посимвольный -- подходит для экранных компонентов, таких как synedit, когда, например, нужно определить третий символ, отображаемый на экране. | |
| 75 | 75 | ||
| 76 | 76 | #### Поиск подстроки | |
| 77 | 77 | ||
| 78 | 78 | Благодаря особенностям UTF-8 для поиска подстроки подходят обычные функции поиска подстроки. Несмотря на мультибайтность, первый байт не может быть спутан со вторым. Поэтому поиск корректной подстроки в UTF-8 при помощи Pos всегда возвращает правильную позицию с точки зрения UTF-8: | |
| 79 | 79 | ||
| 80 | 80 | ``` pascal | |
| 81 | 81 | uses lazutf8; // LCLProc для Lazarus 0.9.30 и ранее | |
| 82 | 82 | ... | |
| 83 | 83 | procedure Where(SearchFor, aText: string); | |
| 84 | 84 | var | |
| 85 | 85 | BytePos: LongInt; | |
| 86 | 86 | CharacterPos: LongInt; | |
| 87 | 87 | begin | |
| 88 | 88 | BytePos:=Pos(SearchFor,aText); | |
| 89 | 89 | CharacterPos:=UTF8Length(PChar(aText),BytePos-1); | |
| 90 | 90 | writeln('Подстрока "',SearchFor,'" начинается в тексте "',aText,'"', | |
| 91 | 91 | ' с байта ',BytePos,', с символа ',CharacterPos); | |
| 92 | 92 | end; | |
| 93 | 93 | ``` | |
| 94 | 94 | ||
| 95 | 95 | Из-за неоднозначности юникода возможно неожиданное поведение Pos() (как и любых сравнений), если одна из строк содержит составные (decomposed) символы, а другая -- их непосредственные коды. RTL не обрабатывает такие случаи автоматически. | |
| 96 | 96 | ||
| 97 | 97 | #### Доступ к символам UTF-8 | |
| 98 | 98 | ||
| 99 | 99 | Юникодные символы могут различаться по длине, поэтому лучшее решение для посимвольного доступа -- последовательный перебор символов. Для перебора символов используйте следующий код: | |
| 100 | 100 | ||
| 101 | 101 | ``` pascal | |
| 102 | 102 | uses lazutf8; // LCLProc для Lazarus 0.9.30 и ранее | |
| 103 | 103 | ... | |
| 104 | 104 | procedure DoSomethingWithString(AnUTF8String: string); | |
| 105 | 105 | var | |
| 106 | 106 | p: PChar; | |
| 107 | 107 | CharLen: integer; | |
| 108 | 108 | FirstByte, SecondByte, ThirdByte: Char; | |
| 109 | 109 | begin | |
| 110 | 110 | p := PChar(AnUTF8String); | |
| 111 | 111 | repeat | |
| 112 | 112 | CharLen := UTF8CharacterLength(p); | |
| 113 | 113 | ||
| 114 | 114 | // У нас есть указатель на символ и его длина | |
| 115 | 115 | // Для побайтного доступа к UTF-8 символу: | |
| 116 | 116 | if CharLen >= 1 then FirstByte := P[0]; | |
| 117 | 117 | if CharLen >= 2 then SecondByte := P[1]; | |
| 118 | 118 | if CharLen >= 3 then ThirdByte := P[2]; | |
| 119 | 119 | ||
| 120 | 120 | inc(p,CharLen); | |
| 121 | 121 | until (CharLen=0) or (p^ = #0); | |
| 122 | 122 | end; | |
| 123 | 123 | ``` | |
| 124 | 124 | ||
| 125 | 125 | #### Доступ к n-му символу UTF-8 | |
| 126 | 126 | ||
| 127 | 127 | Иногда помимо последовательного требуется и произвольный доступ к символам UTF-8. | |
| 128 | 128 | ||
| 129 | 129 | ``` pascal | |
| 130 | 130 | uses lazutf8; // LCLProc для Lazarus 0.9.30 и ранее | |
| 131 | 131 | ... | |
| 132 | 132 | var | |
| 133 | 133 | AnUTF8String, NthChar: string; | |
| 134 | 134 | begin | |
| 135 | 135 | NthChar := UTF8Copy(AnUTF8String, N, 1); | |
| 136 | 136 | ``` | |
| 137 | 137 | ||
| 138 | 138 | #### Получение кодов символов при помощи UTF8CharacterToUnicode | |
| 139 | 139 | ||
| 140 | 140 | Пример демонстрирует получение 32-битного кода каждого символа строки в UTF-8: | |
| 141 | 141 | ||
| 142 | 142 | ``` pascal | |
| 143 | 143 | uses lazutf8; // LCLProc для Lazarus 0.9.30 и ранее | |
| 144 | 144 | ... | |
| 145 | 145 | procedure IterateUTF8Characters(const AnUTF8String: string); | |
| 146 | 146 | var | |
| 147 | 147 | p: PChar; | |
| 148 | 148 | unicode: Cardinal; | |
| 149 | 149 | CharLen: integer; | |
| 150 | 150 | begin | |
| 151 | 151 | p:=PChar(AnUTF8String); | |
| 152 | 152 | repeat | |
| 153 | 153 | unicode:=UTF8CharacterToUnicode(p,CharLen); | |
| 154 | 154 | writeln('Unicode=',unicode); | |
| 155 | 155 | inc(p,CharLen); | |
| 156 | 156 | until (CharLen=0) or (unicode=0); | |
| 157 | 157 | end; | |
| 158 | 158 | ``` | |
| 159 | 159 | ||
| 160 | 160 | #### UTF-8 Copy, Length, LowerCase и т.п. | |
| 161 | 161 | ||
| 162 | 162 | В модуле lazutf8 (LCLProc для Lazarus 0.9.30 и ранее) реализованы практически все операции над строками в UTF-8. Ниже приведён список утилит из lazutf8.pas: | |
| 163 | 163 | ||
| 164 | 164 | ``` pascal | |
| 165 | 165 | function UTF8CharacterLength(p: PChar): integer; | |
| 166 | 166 | function UTF8Length(const s: string): PtrInt; | |
| 167 | 167 | function UTF8Length(p: PChar; ByteCount: PtrInt): PtrInt; | |
| 168 | 168 | function UTF8CharacterToUnicode(p: PChar; out CharLen: integer): Cardinal; | |
| 169 | 169 | function UnicodeToUTF8(u: cardinal; Buf: PChar): integer; inline; | |
| 170 | 170 | function UnicodeToUTF8SkipErrors(u: cardinal; Buf: PChar): integer; | |
| 171 | 171 | function UnicodeToUTF8(u: cardinal): shortstring; inline; | |
| 172 | 172 | function UTF8ToDoubleByteString(const s: string): string; | |
| 173 | 173 | function UTF8ToDoubleByte(UTF8Str: PChar; Len: PtrInt; DBStr: PByte): PtrInt; | |
| 174 | 174 | function UTF8FindNearestCharStart(UTF8Str: PChar; Len: integer; | |
| 175 | 175 | BytePos: integer): integer; | |
| 176 | 176 | // поиск n-го символа UTF-8, без учёта двунаправленности (BIDI) | |
| 177 | 177 | function UTF8CharStart(UTF8Str: PChar; Len, CharIndex: PtrInt): PChar; | |
| 178 | 178 | // поск байтового индекса n-го символа UTF-8, без учёта двунаправленности (BIDI) (длина подстроки в байтах) | |
| 179 | 179 | function UTF8CharToByteIndex(UTF8Str: PChar; Len, CharIndex: PtrInt): PtrInt; | |
| 180 | 180 | procedure UTF8FixBroken(P: PChar); | |
| 181 | 181 | function UTF8CharacterStrictLength(P: PChar): integer; | |
| 182 | 182 | function UTF8CStringToUTF8String(SourceStart: PChar; SourceLen: PtrInt) : string; | |
| 183 | 183 | function UTF8Pos(const SearchForText, SearchInText: string): PtrInt; | |
| 184 | 184 | function UTF8Copy(const s: string; StartCharIndex, CharCount: PtrInt): string; | |
| 185 | 185 | procedure UTF8Delete(var s: String; StartCharIndex, CharCount: PtrInt); | |
| 186 | 186 | procedure UTF8Insert(const source: String; var s: string; StartCharIndex: PtrInt); | |
| 187 | 187 | ||
| 188 | 188 | function UTF8LowerCase(const AInStr: string; ALanguage: string=''): string; | |
| 189 | 189 | function UTF8UpperCase(const AInStr: string; ALanguage: string=''): string; | |
| 190 | 190 | function FindInvalidUTF8Character(p: PChar; Count: PtrInt; | |
| 191 | 191 | StopOnNonASCII: Boolean = false): PtrInt; | |
| 192 | 192 | function ValidUTF8String(const s: String): String; | |
| 193 | 193 | ||
| 194 | 194 | procedure AssignUTF8ListToAnsi(UTF8List, AnsiList: TStrings); | |
| 195 | 195 | ||
| 196 | 196 | //функции сравнения | |
| 197 | 197 | ||
| 198 | 198 | function UTF8CompareStr(const S1, S2: string): Integer; | |
| 199 | 199 | function UTF8CompareText(const S1, S2: string): Integer; | |
| 200 | 200 | ``` | |
| 201 | 201 | ||
| 202 | 202 | ### Работа с именами файлов и каталогов | |
| 203 | 203 | ||
| 204 | 204 | Элементы управления и функции Lazarus ожидают имена файлов и каталогов в кодировке UTF-8, но RTL использует для таких имён строки в ANSI. | |
| 205 | 205 | ||
| 206 | 206 | Например, пусть кнопка назначает текущий каталог свойству Directory элемента TFileListBox. Функция RTL [[doc:rtl/sysutils/getcurrentdir.html|GetCurrentDir]] использует ANSI, а не юникод, поэтому требуется преобразование: | |
| 207 | 207 | ||
| 208 | 208 | ``` pascal | |
| 209 | 209 | procedure TForm1.Button1Click(Sender: TObject); | |
| 210 | 210 | begin | |
| 211 | 211 | FileListBox1.Directory:=SysToUTF8(GetCurrentDir); | |
| 212 | 212 | // или с помощью функциий из модуля FileUtil | |
| 213 | 213 | FileListBox1.Directory:=GetCurrentDirUTF8; | |
| 214 | 214 | end; | |
| 215 | 215 | ``` | |
| 216 | 216 | ||
| 217 | 217 | Модуль FileUtil содержит общие файловые функции в варианте UTF-8: | |
| 218 | 218 | ||
| 219 | 219 | ``` pascal | |
| 220 | 220 | // основные функции как в RTL, но в кодировке UTF-8 | |
| 221 | 221 | // вместо системной | |
| 222 | 222 | ||
| 223 | 223 | // AnsiToUTF8 и UTF8ToAnsi требуют менеджер широких строк в Linux, BSD, macOS, | |
| 224 | 224 | // но эти ОС обычно используют в качестве системной кодировки UTF-8, | |
| 225 | 225 | // и тогда менеджер не нужен. | |
| 226 | 226 | function NeedRTLAnsi: boolean;// истина если системная кодировка не UTF-8 | |
| 227 | 227 | procedure SetNeedRTLAnsi(NewValue: boolean); | |
| 228 | 228 | function UTF8ToSys(const s: string): string;// как UTF8ToAnsi, но более независима от менеджера широких строк | |
| 229 | 229 | function SysToUTF8(const s: string): string;// как AnsiToUTF8, но более независима от менеджера широких строк | |
| 230 | 230 | ||
| 231 | 231 | // операции с файлами | |
| 232 | 232 | function FileExistsUTF8(const Filename: string): boolean; | |
| 233 | 233 | function FileAgeUTF8(const FileName: string): Longint; | |
| 234 | 234 | function DirectoryExistsUTF8(const Directory: string): Boolean; | |
| 235 | 235 | function ExpandFileNameUTF8(const FileName: string): string; | |
| 236 | 236 | function ExpandUNCFileNameUTF8(const FileName: string): string; | |
| 237 | 237 | {$IFNDEF VER2_2_0} | |
| 238 | 238 | function ExtractShortPathNameUTF8(Const FileName : String) : String; | |
| 239 | 239 | {$ENDIF} | |
| 240 | 240 | function FindFirstUTF8(const Path: string; Attr: Longint; out Rslt: TSearchRec): Longint; | |
| 241 | 241 | function FindNextUTF8(var Rslt: TSearchRec): Longint; | |
| 242 | 242 | procedure FindCloseUTF8(var F: TSearchrec); | |
| 243 | 243 | function FileSetDateUTF8(const FileName: String; Age: Longint): Longint; | |
| 244 | 244 | function FileGetAttrUTF8(const FileName: String): Longint; | |
| 245 | 245 | function FileSetAttrUTF8(const Filename: String; Attr: longint): Longint; | |
| 246 | 246 | function DeleteFileUTF8(const FileName: String): Boolean; | |
| 247 | 247 | function RenameFileUTF8(const OldName, NewName: String): Boolean; | |
| 248 | 248 | function FileSearchUTF8(const Name, DirList : String): String; | |
| 249 | 249 | function FileIsReadOnlyUTF8(const FileName: String): Boolean; | |
| 250 | 250 | function GetCurrentDirUTF8: String; | |
| 251 | 251 | function SetCurrentDirUTF8(const NewDir: String): Boolean; | |
| 252 | 252 | function CreateDirUTF8(const NewDir: String): Boolean; | |
| 253 | 253 | function RemoveDirUTF8(const Dir: String): Boolean; | |
| 254 | 254 | function ForceDirectoriesUTF8(const Dir: string): Boolean; | |
| 255 | 255 | ||
| 256 | 256 | // окружение | |
| 257 | 257 | function ParamStrUTF8(Param: Integer): string; | |
| 258 | 258 | function GetEnvironmentStringUTF8(Index : Integer): String; | |
| 259 | 259 | function GetEnvironmentVariableUTF8(const EnvVar: String): String; | |
| 260 | 260 | function GetAppConfigDirUTF8(Global: Boolean): string; | |
| 261 | 261 | ``` | |
| 262 | 262 | ||
| 263 | 263 | ### Восточно-азиатские языки в Windows | |
| 264 | 264 | ||
| 265 | 265 | Шрифт элементов управления пользовательского интерфейса по умолчанию (Tahoma) в Windows XP в состоянии правильно отображать несколько письменностей/алфавитов/языков, включая арабский, русский (кириллица) и западноевропейские языки (латинский/греческий алфавиты), но не восточно-азиатские как китайский, японский и корейский. | |
| 266 | 266 | ||
| 267 | 267 | Для корректного отображения указанных языков стандартным шрифтом достаточно в Панели управления выбрать Региональные настройки, щёлкнуть вкладку Языки и установить поддержку восточно-азиатских языков. Естественно, что в версиях Windows XP на указанных языках этот пакет включён по умолчанию. Дополнительные инструкции [здесь](http://newton.uor.edu/Departments&Programs/AsianStudiesDept/Language/asianlanguageinstallation_XP.html). | |
| 268 | 268 | ||
| 269 | 269 | Более позднее версии Windows скорее всего не требуют установки дополнений для поддержки указанных языков. | |
| 270 | 270 | ||
| 271 | 271 | ## Особенности Free Pascal | |
| 272 | 272 | ||
| 273 | 273 | ### UTF-8 и исходные файлы -- отсутствие BOM | |
| 274 | 274 | ||
| 275 | 275 | Когда в созданном в Lazarus файле исходного кода используются не-ASCII символы, он сохраняется в UTF-8. При этом **не** используется **BOM** (Byte Order Mark -- маркер порядка байтов). Кодировку можно изменить при помощи правого щелчка по редактору кода / File Settings / Encoding. Помимо того, что файлы в UTF-8 не обязаны иметь BOM, причина его отсутствия скорее в том, как FPC обрабатывает строки AnsiString. LCL использует AnsiString для совместимости и UTF-8 для переносимости. | |
| 276 | 276 | ||
| 277 | 277 | Примечание. Некоторые текстовые редакторы в MS Windows могут полагать, что файлы используют системную кодовую страницу (кодировку OEM) и отображают в них неправильные символы. Не добавляйте BOM. Если добавить BOM, то придётся изменить все строковые присваивания. | |
| 278 | 278 | ||
| 279 | 279 | Пример: | |
| 280 | 280 | ||
| 281 | 281 | ``` pascal | |
| 282 | 282 | Button1.Caption := 'Über'; | |
| 283 | 283 | ``` | |
| 284 | 284 | ||
| 285 | 285 | Когда отсутствует BOM (и кодировка не задана параметром) компилятор считает, что строка в системной кодировке и копирует каждый байт в строку без преобразований. LCL ожидает строки именно в таком виде. | |
| 286 | 286 | ||
| 287 | 287 | ``` pascal | |
| 288 | 288 | // исходный файл сохранён в UTF без BOM | |
| 289 | 289 | if FileExists('Über.txt') then ; // неправильно, FileExists ожидает системную кодировку | |
| 290 | 290 | if FileExistsUTF8('Über.txt') then ; // правильно | |
| 291 | 291 | ``` | |
| 292 | 292 | ||
| 293 | 293 | ## Основы юникода | |
| 294 | 294 | ||
| 295 | 295 | Стандарт Unicode сопоставляет целые от 0 до 10FFFF(h) символам. Каждое такое сопоставление именуется кодовой точкой (code point). Другими словами, юникодные символы определены для кодовых точек от U+000000 до U+10FFFF (от 0 до 1 114 111). | |
| 296 | 296 | ||
| 297 | 297 | Для представления кодовых точек как уникальных байтовых последовательностей существуют три основных схемы. Эти схемы называют форматами юникодных преобразований: UTF-8, UTF-16 и UTF-32. Преобразование между всеми ними возможно. Их основные свойства: | |
| 298 | 298 | ||
| 299 | 299 | ` UTF-8 UTF-16 UTF-32`\ | |
| 300 | 300 | `Наименьшая кодовая точка [16] 000000 000000 000000`\ | |
| 301 | 301 | `Наибольшая кодовая точка [16] 10FFFF 10FFFF 10FFFF`\ | |
| 302 | 302 | `Размер кодового элемента [бит] 8 16 32`\ | |
| 303 | 303 | `Минимум байт на символ 1 2 4`\ | |
| 304 | 304 | `Максимум байт на символ 4 4 4` | |
| 305 | 305 | ||
| 306 | 306 | **UTF-8** обладает несколькими важными и полезными свойствами: Содержимое интерпретируется как последовательность байтов, поэтому понятие порядка байт "от младшего" или "от старшего" отсутствует. Юникодные символы от U+0000 до U+007F (ASCII) кодируются байтами от 00h до 7Fh (совместимо с ASCII). Это значит, что файлы и строки, содержащие только 7-битные символы ASCII, кодируются одинаково в ASCII и в UTF-8. Все символы больше U+007F кодируются как последовательность нескольких байтов, у каждого из которых старшие биты установлены в 1. Последовательность байт одного символа заведомо не содержится в более длинной последовательности байт другого символа. Это позволяет без затруднений искать подстроки. Первый байт мультибайтовой последовательности (представляющей не-ASCII символ) всегда принадлежит диапазону от C0h до FDh и показывает количество последующих байт для этого символа. Все последующие байты мультибайтной последовательности принадлежат диапазону от 80h до BFh. Это позволяет легко выполнять ресинхронизацию и способствует надежности. | |
| 307 | 307 | ||
| 308 | 308 | **UTF-16** обладает следующими важными свойствами: Используется одно 16-битное слово для кодирования символов от U+0000 до U+d7ff и два 16-битных слова для кодирования всех остальных символов. | |
| 309 | 309 | ||
| 310 | 310 | В заключение, любой юникодный символ возможно представить как один 4-байтный/32-битный элемент в **UTF-32**. | |
| 311 | 311 | ||
| 312 | 312 | См. также: [Unicode FAQ - Basic questions](http://www.unicode.org/faq/basic_q.html), [Unicode FAQ - UTF-8, UTF-16, UTF-32 & BOM](http://www.unicode.org/faq/utf_bom.html), [Wikipedia: UTF-8](http://en.wikipedia.org/wiki/UTF-8) [1](http://en.wikipedia.org/wiki/ISO-8859) | |
| 313 | 313 | ||
| 314 | 314 | # Детали реализации | |
| 315 | 315 | ||
| 316 | 316 | ## Lazarus/LCL обычно использует только UTF-8 | |
| 317 | 317 | ||
| 318 | 318 | Начиная с Lazarus 0.9.31 интерфейс GTK1 объявлен устаревшим, все интерфейсы LCL совместимы с юникодом, Lazarus и LCL используют строки только в кодировке UTF-8, если явно не указано, что функция/процедура принимает другие кодировки. | |
| 319 | 319 | ||
| 320 | 320 | ## Перевод интерфейса Win32 на юникод | |
| 321 | 321 | ||
| 322 | 322 | ### Обзор | |
| 323 | 323 | ||
| 324 | 324 | Сперва, и это самое важное, во избежание поломки существующего интерфейса ANSI следует все юникодные интерфейсные модификации заключить в IFDEF WindowsUnicodeSupport. После стабилизации модификаций все IFDEF-ы будут убраны и останется только юникодная часть. К тому моменту все существующие программы, использующие символы ANSI, потребуют миграции на юникод. | |
| 325 | 325 | ||
| 326 | 326 | ### Win9x не поддерживает юникод | |
| 327 | 327 | ||
| 328 | 328 | Платформы \<= Win9x основаны на стандартах кодовых страниц ISO и поддерживают юникод только частично. Платформы Windows, начиная с WinNT, и Windows CE юникод поддерживают полностью. | |
| 329 | 329 | ||
| 330 | 330 | Win 9x и NT предлагают два параллельных набора функций API: *A -- старый под ANSI, *W -- новый юникодный. Функции *W принимают в качестве параметров широкие строки, то есть строки в кодировке UTF-16. В Windows 9x присутствуют все функции *W, но имеют пустые реализации. Поэтому они ничего не делают. Но некоторые из них реализованы полностью даже в 9x и перечислены ниже в разделе "Широкие функции, присутствующие в Windows 9x". Это свойство актуально, поскольку позволяет иметь одно приложение для Win9x и WinNT и во время его исполнения определять, какой набор API использовать. | |
| 331 | 331 | ||
| 332 | 332 | Windows CE использует только широкие функции API. | |
| 333 | 333 | ||
| 334 | 334 | #### Широкие функции, присутствующие в Windows 9x | |
| 335 | 335 | ||
| 336 | 336 | Некоторые функции широкого API присутствуют в Windows 9x. Вот список таких функций: <http://support.microsoft.com/kb/210341> | |
| 337 | 337 | ||
| 338 | 338 | Пример преобразования: | |
| 339 | 339 | ||
| 340 | 340 | ``` pascal | |
| 341 | 341 | GetTextExtentPoint32(hdcNewBitmap, LPSTR(ButtonCaption), | |
| 342 | 342 | Length(ButtonCaption), TextSize); | |
| 343 | 343 | ``` | |
| 344 | 344 | ||
| 345 | 345 | Станет: | |
| 346 | 346 | ||
| 347 | 347 | ``` pascal | |
| 348 | 348 | {$ifdef WindowsUnicodeSupport} | |
| 349 | 349 | GetTextExtentPoint32W(hdcNewBitmap, PWideChar(Utf8Decode(ButtonCaption)), Length(WideCaption), TextSize); | |
| 350 | 350 | {$else} | |
| 351 | 351 | GetTextExtentPoint32(hdcNewBitmap, LPSTR(ButtonCaption), Length(ButtonCaption), TextSize); | |
| 352 | 352 | {$endif} | |
| 353 | 353 | ``` | |
| 354 | 354 | ||
| 355 | 355 | #### Функции, требующие версий Ansi и Wide | |
| 356 | 356 | ||
| 357 | 357 | Пример преобразования: | |
| 358 | 358 | ||
| 359 | 359 | ``` pascal | |
| 360 | 360 | function TGDIWindow.GetTitle: String; | |
| 361 | 361 | var | |
| 362 | 362 | l: Integer; | |
| 363 | 363 | begin | |
| 364 | 364 | l := Windows.GetWindowTextLength(Handle); | |
| 365 | 365 | SetLength(Result, l); | |
| 366 | 366 | Windows.GetWindowText(Handle, @Result[1], l); | |
| 367 | 367 | end; | |
| 368 | 368 | ``` | |
| 369 | 369 | ||
| 370 | 370 | Станет: | |
| 371 | 371 | ||
| 372 | 372 | ``` pascal | |
| 373 | 373 | function TGDIWindow.GetTitle: String; | |
| 374 | 374 | var | |
| 375 | 375 | l: Integer; | |
| 376 | 376 | AnsiBuffer: string; | |
| 377 | 377 | WideBuffer: WideString; | |
| 378 | 378 | begin | |
| 379 | 379 | ||
| 380 | 380 | {$ifdef WindowsUnicodeSupport} | |
| 381 | 381 | ||
| 382 | 382 | if UnicodeEnabledOS then | |
| 383 | 383 | begin | |
| 384 | 384 | l := Windows.GetWindowTextLengthW(Handle); | |
| 385 | 385 | SetLength(WideBuffer, l); | |
| 386 | 386 | l := Windows.GetWindowTextW(Handle, @WideBuffer[1], l); | |
| 387 | 387 | SetLength(WideBuffer, l); | |
| 388 | 388 | Result := Utf8Encode(WideBuffer); | |
| 389 | 389 | end | |
| 390 | 390 | else | |
| 391 | 391 | begin | |
| 392 | 392 | l := Windows.GetWindowTextLength(Handle); | |
| 393 | 393 | SetLength(AnsiBuffer, l); | |
| 394 | 394 | l := Windows.GetWindowText(Handle, @AnsiBuffer[1], l); | |
| 395 | 395 | SetLength(AnsiBuffer, l); | |
| 396 | 396 | Result := AnsiToUtf8(AnsiBuffer); | |
| 397 | 397 | end; | |
| 398 | 398 | ||
| 399 | 399 | {$else} | |
| 400 | 400 | ||
| 401 | 401 | l := Windows.GetWindowTextLength(Handle); | |
| 402 | 402 | SetLength(Result, l); | |
| 403 | 403 | Windows.GetWindowText(Handle, @Result[1], l); | |
| 404 | 404 | ||
| 405 | 405 | {$endif} | |
| 406 | 406 | ||
| 407 | 407 | end; | |
| 408 | 408 | ``` | |
| 409 | 409 | ||
| 410 | 410 | ### Снимки экрана | |
| 411 | 411 | ||
| 412 | - | ||
| 413 | - | ||
| 414 | - | ||
| 415 | - | ||
| 412 | + | 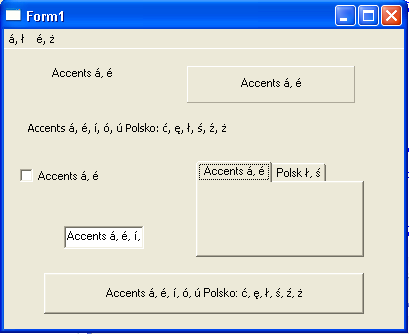 | |
| 416 | 413 | ||
| 417 | 414 | # Кодовые страницы FPC | |
| 418 | 415 | ||
| 419 | 416 | Почему LCL не использует кодовые страницы для исходных текстов? | |
| 420 | 417 | ||
| 421 | 418 | -Fcutf8 и {\$codepage utf8} существуют не первый год. | |
| 422 | 419 | ||
| 423 | 420 | Следующие программы требуют FPC 2.7.1. Описанные трудности существуют и на более старых компиляторах. | |
| 424 | 421 | ||
| 425 | 422 | Есть в использовании -Fcutf8 и {\$codepage utf8} несколько ловушек. Директивы работают, если DefaultSystemCodePage из RTL возвращает CP_UTF8. Иначе компилятор перекодирует строки. Например, в Linux умолчание для RTL -- CP_ACP, что по умолчанию ISO_8859-1. RTL самостоятельно **не** читает язык из переменных окружения. Поэтому умолчанием будет ISO_8859-1. Это означает, что строковые константы в UTF-8 будут преобразованы компилятором. | |
| 426 | 423 | ||
| 427 | 424 | Откомпилируйте с -Fcutf8 и запустите в Linux с LANG в utf-8: | |
| 428 | 425 | ||
| 429 | 426 | ``` pascal | |
| 430 | 427 | program project1; | |
| 431 | 428 | {$mode objfpc}{$H+} | |
| 432 | 429 | begin | |
| 433 | 430 | writeln(DefaultSystemCodePage,' ',CP_UTF8); | |
| 434 | 431 | writeln('ä'); | |
| 435 | 432 | end. | |
| 436 | 433 | ``` | |
| 437 | 434 | ||
| 438 | 435 | Результат: | |
| 439 | 436 | ||
| 440 | 437 | 0 65001 | |
| 441 | 438 | ä | |
| 442 | 439 | ||
| 443 | 440 | LCL использует widestringmanager -- менеджер широких строк (в настоящее время cwstring), который назначает DefaultSystemCodePage. Тоже самое можно сделать и в не-LCL программах: | |
| 444 | 441 | ||
| 445 | 442 | ``` pascal | |
| 446 | 443 | program project1; | |
| 447 | 444 | {$mode objfpc}{$H+} | |
| 448 | 445 | uses cwstring; | |
| 449 | 446 | begin | |
| 450 | 447 | writeln(DefaultSystemCodePage,' ',CP_UTF8); | |
| 451 | 448 | writeln('ä'); | |
| 452 | 449 | end. | |
| 453 | 450 | ``` | |
| 454 | 451 | ||
| 455 | 452 | Результат: | |
| 456 | 453 | ||
| 457 | 454 | 65001 65001 | |
| 458 | 455 | ä | |
| 459 | 456 | ||
| 460 | 457 | Приведённый выше код прост и понятен, жаль только, что работает подобное лишь в простейших случаях. Посмотрим на программу ниже: | |
| 461 | 458 | ||
| 462 | 459 | ``` pascal | |
| 463 | 460 | program project1; | |
| 464 | 461 | {$mode objfpc}{$H+} | |
| 465 | 462 | uses cwstring; | |
| 466 | 463 | var | |
| 467 | 464 | a,b,c: string; | |
| 468 | 465 | begin | |
| 469 | 466 | writeln(DefaultSystemCodePage,' ',CP_UTF8); | |
| 470 | 467 | a:='ä'; b:='='#$C3#$A4; // #$C3#$A4 это UTF-8 для ä | |
| 471 | 468 | c:= 'ä='#$C3#$A4; | |
| 472 | 469 | writeln(a,b); // writes ä=ä | |
| 473 | 470 | writeln(c); // writes ä=ä | |
| 474 | 471 | end. | |
| 475 | 472 | ``` | |
| 476 | 473 | ||
| 477 | 474 | 65001 65001 | |
| 478 | 475 | ä=ä | |
| 479 | 476 | ä=ä | |
| 480 | 477 | ||
| 481 | 478 | Посмотрите, работают строковые константы в UTF-8, строковые константы с кодами UTF-8, но не их комбинация. Приведённый выше код скомпилирован с -Fcutf8 и использует cwstring для установки DefaultSystemCodePage в CP_UTF8. | |
| 482 | 479 | ||
| 483 | 480 | Так что же пошло не так? | |
| 484 | 481 | ||
| 485 | 482 | Компилятор обрабатывает строковые не-ASCII константы (здесь -- ä) как широкие строки (UCS2, не UTF-16). | |
| 486 | 483 | ||
| 487 | 484 | Одурачить компилятор при помощи 'ä='+#\$C3#\$A4 не выйдет. Придётся определить две отдельные строковые константы. | |
| 488 | 485 | ||
| 489 | 486 | Использование символов не из диапазона UCS-2 приведёт к | |
| 490 | 487 | ||
| 491 | 488 | Fatal: illegal character "'�'" ($F0) | |
| 492 | 489 | ||
| 493 | 490 | Но можно указать их в кодах UTF-16: *\#\$D834#\$DD1E*. Да, прочитали правильно. Указание кодовой страницы при помощи -Fcutf8 или {\$codepage utf8} действительно определяет смесь UTF-8 и UTF-16. | |
| 494 | 491 | ||
| 495 | 492 | Теперь откомпилируйте приведённый выше код без -Fcutf8: | |
| 496 | 493 | ||
| 497 | 494 | 65001 65001 | |
| 498 | 495 | ä=ä | |
| 499 | 496 | ä=ä | |
| 500 | 497 | ||
| 501 | 498 | Вот это да, всё как хотелось. Можно даже смешивать строковые константы в ASCII и не-ASCII. Без указания кодовой страницы компилятор просто сохраняет строковые константы как последовательности байтов. А это и есть UTF-8. | |
| 502 | 499 | ||
| 503 | 500 | В этом одна из причин того, почему LCL приложения не используют флаги кодировок. | |
| 504 | 501 | ||
| 505 | 502 | В msegui реализована экосистема широких строк, которая работает лучше, чем кодовые страницы. | |
| 506 | 503 | ||
| 507 | 504 | # RTL с кодовой страницей UTF-8 по умолчанию | |
| 508 | 505 | ||
| 509 | 506 | **Эксперимент -- требуется тестирование под Windows!** | |
| 510 | 507 | ||
| 511 | 508 | Обычно RTL использует для строк системную кодовую страницу (например, FileExists или TStringList.LoadFromFile). Под Windows RTL не использует юникод, вам недоступны символы вне вашей языковой группы. LCL работает с кодировкой UTF-8, поддерживающей все символы юникода. Под Linux и macOS системной кодовой страницей обычно является UTF-8, поэтому для них RTL по умолчанию использует CP_UTF8. | |
| 512 | 509 | ||
| 513 | 510 | Начиная с FPC 2.7.1 кодовая страница, используемая RTL по умолчанию, может быть изменена на UTF-8 (CP_UTF8). Таким образом, пользователи Windows теперь смогут использовать в RTL строки UTF-8. Для тестирования добавьте -dEnableUTF8RTL в *Lazarus build options* (параметры сборки проекта) и пересоберите проект. | |
| 514 | 511 | ||
| 515 | 512 | - Например, FileExists и aStringList.LoadFromFile(Filename) теперь полностью поддерживают юникод. Полный перечень функций, уже поддерживающих юникод полностью, смотрите по ссылке: | |
| 516 | 513 | ||
| 517 | 514 | <http://wiki.freepascal.org/FPC_Unicode_support#RTL_changes> | |
| 518 | 515 | ||
| 519 | 516 | - *AnsiToUTF8, UTF8ToAnsi, SysToUTF8, UTF8ToAnsi* не действуют. Они использовались преимущественно для вышеуказанных функций, которые больше не требуют преобразований аргументов и результата. | |
| 520 | 517 | - Многочисленные явные вызовы *UTF8Encode* и *UTF8Decode* больше не нужны, поскольку при присваивании строки в *UnicodeString* строке String и наоборот компилятор сделает это автоматически. | |
| 521 | 518 | - При обращении к WinAPI необходимо использовать функции с "W" либо пользоваться функциями **UTF8ToWinCP** и **WinCPToUTF8**. | |
| 522 | 519 | - Включить новый режим можно перекомпилировав Lazarus с **-dEnableUTF8RTL**. | |
| 523 | 520 | - Если используете строковые литералы с **WideString**, **UnicodeString** или **UTF8String**, то теперь исходные тексты **должны** быть в соответствующей кодировке. Например, можно использовать исходные тексты в UTF-8 (поведение Lazarus по умолчанию) и передавать компилятору параметр **-FcUTF8**. | |
| 524 | 521 | - "String" и "UTF8String" -- разные типы. При присваивании *String* переменной в *UTF8String* компилятор добавляет код проверки соответствия кодировок. Это повлечёт увеличение времени исполнения и размера машинного кода. | |
| 525 | 522 | ||
| 526 | 523 | Дополнительную информацию о новой поддержке юникода в FPC см. по ссылке: <http://wiki.freepascal.org/FPC_Unicode_support> | |
| 527 | 524 | ||
| 528 | 525 | # См. также | |
| 529 | 526 | ||
| 530 | 527 | - [[UTF-8]] - Описание строк в UTF-8 | |
| 531 | 528 | ||
| 532 | 529 | --- | |
| 533 | 530 | *From the Free Pascal wiki, page "LCL Unicode Support/ru", as it stood on 2019-12-22 after a change by Trev, out of the wiki's dump of 2024-05-26. Copyright stays with the author who wrote it, according to the old wiki's [[Licensing]] page. If you have concerns about this material, [message the admin](/wiki-contact).* | |
| 534 | 531 | Category: FPC/ru | |
| 535 | 532 | Category: LCL/ru | |
| 536 | 533 | Category: Russian | |
| 537 | 534 | Category: Unicode/ru |