

LCL Unicode Support/ko: what changed
Revision 1 to 2. Removed lines have a minus sign; added lines have a plus sign.
| Old | New | Line | |
|---|---|---|---|
| 1 | 1 | ## 소개 | |
| 2 | 2 | ||
| 3 | 3 | 0.9.25 에서 라자루스는 Gtk1을 제외한 모든 플랫폼에서 유니코드를 완전하게 지원하게 되었다. 이 페이지는 FPC 2.6.4를 사용하는 라자루스 1.4 까지의 유니코드에 대해 다룬다. 2.0을 시작하면서 라자루스는 FPC 3.0+의 특징을 사용하여 유니코드 지원을 개선하였다. 자세한 내용은 다음을 보시길 : [[Unicode Support in Lazarus|라자루스에서 개선 된 유니코드 지원]] | |
| 4 | 4 | ||
| 5 | 5 | ## 사용자를 위한 지침 | |
| 6 | 6 | ||
| 7 | 7 | 라자루스가 유니코드 위젯 세트를 가지고 있다지만 모든 것이 유니코드가 아니란 것을 알아야 한다. 문자열 인코딩의 시작이 무엇인지 알고 다른 인코딩을 필요로하는 라이브러리간에 적절히 인코딩하는 것은 개발자의 책임이다. | |
| 8 | 8 | ||
| 9 | 9 | 보통 인코딩은 라이브러리 단위로 이루어진다(예를 들면, 동적 라이브러리인 DLL이나 라자루스 패키지). 각 라이브러리는 한 종류의 인코딩만을 요구하고, 이것들은 대개 Unicode(라자루스에서는 UTF-8) 또는 ANSI 이다(이것은 실제로는 시스템 인코딩으로 UTF-8 이거나 아니라는 뜻이다). 2.6 이하의 FPC의 RTL 과 FCL 은 ANSI 문자열이 필요하다. | |
| 10 | 10 | ||
| 11 | 11 | 유니코드와 ANSI는 다음 코드를 사용하여 변환할 수 있다. | |
| 12 | 12 | ||
| 13 | 13 | - **UTF8ToAnsi** 와 **AnsiToUTF8**은 (FPC) System 유닛에서 기능한다. | |
| 14 | 14 | - 또는 **UTF8ToSys** 와 **SysToUTF8**은 (Lazarus) FileUtil 유닛에서 기능한다. | |
| 15 | 15 | ||
| 16 | 16 | 두번째 것이 더 빠르고 산뜻하지만 더 많은 코드가 프로그램에 들어가게 된다. | |
| 17 | 17 | ||
| 18 | 18 | - FileUtil:UTF8ToSys 에서 LazUTF8:UTF8ToSys 로 변경되었다. \[1.8.2버전\] | |
| 19 | 19 | ||
| 20 | 20 | ### FPC 는 유니코드를 알고 있지 않다 | |
| 21 | 21 | ||
| 22 | 22 | 현재의 FPC버전(2.6.x 이하)에서 프리파스칼 런타임 라이브러리(RTL)과 프리파스칼 컴포넌트 라이브러리(FCL)은 ANSI라서 유니코드 라이브러리에서 가져오거나 유니코드 라이브러리로 보내는(예, LCL) 경우에는 문자열 변환이 필요하다. | |
| 23 | 23 | ||
| 24 | 24 | String 을 포함하여 FPC 2.7.1 계열의 개발 버전에 중요한 개선점들이 있다. RawByteString 과 UTF8String 에 대해서는 [[FPC Unicode support|FPC의 유니코드 지원]] 을 보세요. | |
| 25 | 25 | ||
| 26 | 26 | ### ANSI 와 Unicode 간의 변환 | |
| 27 | 27 | ||
| 28 | 28 | > **Note:** AnsiToUTF8 와 UTF8ToAnsi 는 리눅스, BSD, Mac OS X 에서 사용할 경우 widestring 관리자가 필요하다. SysToUTF8 과 UTF8ToSys 함수를 사용할 수 있다.(unit FileUtil) 또는 프로그램이 사용하는 첫번째 uses 섹션에 cwstring을 추가하여 widestring 매니저를 추가할 수 있게된다. | |
| 29 | 29 | ||
| 30 | 30 | 예: | |
| 31 | 31 | ||
| 32 | 32 | TEdit에서 문자열을 얻고 어떤 RTL 파일 루틴에 문자열을 보내고 싶다고 하자. | |
| 33 | 33 | ||
| 34 | 34 | ``` pascal | |
| 35 | 35 | var | |
| 36 | 36 | MyString: string; // utf-8 로 인코드 되어 있다. | |
| 37 | 37 | begin | |
| 38 | 38 | MyString := MyTEdit.Text; | |
| 39 | 39 | SomeRTLRoutine(UTF8ToAnsi(MyString)); | |
| 40 | 40 | end; | |
| 41 | 41 | ``` | |
| 42 | 42 | ||
| 43 | 43 | 반대로 보낼 경우에는: | |
| 44 | 44 | ||
| 45 | 45 | ``` pascal | |
| 46 | 46 | var | |
| 47 | 47 | MyString: string; // ANSI 로 인코드 되어 있다. | |
| 48 | 48 | begin | |
| 49 | 49 | MyString := SomeRTLRoutine; | |
| 50 | 50 | MyTEdit.Text := AnsiToUTF8(MyString); | |
| 51 | 51 | end; | |
| 52 | 52 | ``` | |
| 53 | 53 | ||
| 54 | 54 | ### Widestrings 과 Ansistrings | |
| 55 | 55 | ||
| 56 | 56 | widestring 은 2-바이트 크기의 요소를 가지는 기본 데이터의 문자열 타입이다. Widestring은 거의 대부분 UTF-16 로 인코딩된 데이터를 가진다. [[Widestrings|widestring]] 을 보세요 | |
| 57 | 57 | ||
| 58 | 58 | Widestring의 배열로 억세스할 수 있는 각 데이터 포인트는 2 바이트를 가지며, UTF-16에서 문자(character)는 1 또는 2 데이터 포인트일 수 있어서, 2 또는 4 바이트를 차지할 수 있다. 이는 Widestring을 배열로 접근하고 이러한 방법으로 UTF-16 문자들을 얻으려고 하는 것은 **확실히 잘못된 것**이어서 문자열에 4 바이트 문자가 들어있을 때는 실패하게 될 것이다. 또한 UTF-8 과 마찬가지로 UTF-16은 분리되는 문자를 가질 수도 있다. 예를 들어 문자 "Á" 는 단일 문자로 인코드할 수 있거나 두개의 문자로 인코드 될 수도 있다: "A" + 수정 액센트. 그러므로 Unicode에서 엑센트 문자를 가진 문장은 다양한 방법으로 인코딩 될 수 있어서 라자루스나 FPC는 자동으로 이들을 다룰 수가 없다. | |
| 59 | 59 | ||
| 60 | 60 | Ansistrings 를 Widestrings 로 전달할 때 인코딩을 변환해야 한다. | |
| 61 | 61 | ||
| 62 | 62 | ``` pascal | |
| 63 | 63 | var | |
| 64 | 64 | w: widestring; | |
| 65 | 65 | begin | |
| 66 | 66 | w:='Über'; // 틀림, FPC 는 시스템 코드페이지를 UTF16 로 변경할 것이다. | |
| 67 | 67 | w:=UTF8ToUTF16('Über'); // 맞음 | |
| 68 | 68 | Button1.Caption:=UTF16ToUTF8(w); | |
| 69 | 69 | end; | |
| 70 | 70 | ``` | |
| 71 | 71 | ||
| 72 | 72 | ### UTF8 문자열 과 문자들 | |
| 73 | 73 | ||
| 74 | 74 | Lazarus 0.9.30 까지 UTF-8 핸들링 루틴은 LCLProc 유닛 내의 LCL에 있었다. 라자루스 0.9.31+에서 LCLProc 내의 루틴들은 여전히 호환성 문제 때문에 쓸모가 있으나 UTF-8을 다루는 실제코드는 lazutf8 유닛내의 lazutils 패키지에 있다. UTF-8 문자열상에서 실행하기 위해서는 프리파스칼에서 온 SysUtils 루틴 대신에 lazutf8 유닛에 있는 루틴을 사용하는게 좋은데 이는, SysUtils 은 유니코드를 다룰 준비가 되어있지 않으나, lazutf8은 사용할 준비가 되어있기 때문이다. 간단히 Sysutils의 루틴을 lazutf8에 있는 같은 루틴으로 바꾸면 되는데 UTF8 선행사가 붙은 것을 제외하고는 이름이 같기 때문이다. | |
| 75 | 75 | ||
| 76 | 76 | #### UTF-8 String Copy, Length, LowerCase, 등등 | |
| 77 | 77 | ||
| 78 | 78 | UTF-8문자열로 실행하기 원하는 거의 모든 동작들은 lazutf 유닛의 루틴으로 대치할 수 있다.(라자루스 0.9.30 이상에서는 LCLProc 유닛) 다음과 같이 lazurf8.pas 에서 나온 루틴의 리스트를 보세요 | |
| 79 | 79 | ||
| 80 | 80 | ``` pascal | |
| 81 | 81 | function UTF8CharacterLength(p: PChar): integer; // 문자의 길이 | |
| 82 | 82 | function UTF8Length(const s: string): PtrInt; // 문자열의 길이 | |
| 83 | 83 | function UTF8Length(p: PChar; ByteCount: PtrInt): PtrInt; | |
| 84 | 84 | function UTF8CharacterToUnicode(p: PChar; out CharLen: integer): Cardinal; | |
| 85 | 85 | function UnicodeToUTF8(u: cardinal; Buf: PChar): integer; inline; | |
| 86 | 86 | function UnicodeToUTF8SkipErrors(u: cardinal; Buf: PChar): integer; | |
| 87 | 87 | function UnicodeToUTF8(u: cardinal): shortstring; inline; | |
| 88 | 88 | function UTF8ToDoubleByteString(const s: string): string; | |
| 89 | 89 | function UTF8ToDoubleByte(UTF8Str: PChar; Len: PtrInt; DBStr: PByte): PtrInt; | |
| 90 | 90 | function UTF8FindNearestCharStart(UTF8Str: PChar; Len: integer; | |
| 91 | 91 | BytePos: integer): integer; | |
| 92 | 92 | // n-번째 UTF8 문자를 찿으며, BIDI 는 무시한다. | |
| 93 | 93 | function UTF8CharStart(UTF8Str: PChar; Len, CharIndex: PtrInt): PChar; | |
| 94 | 94 | // n-번째 UTF8 문자릐 바이트 인덱스를 찾되, BIDI (substr 의 바이트 길이)는 무시한다. | |
| 95 | 95 | function UTF8CharToByteIndex(UTF8Str: PChar; Len, CharIndex: PtrInt): PtrInt; | |
| 96 | 96 | procedure UTF8FixBroken(P: PChar); | |
| 97 | 97 | function UTF8CharacterStrictLength(P: PChar): integer; | |
| 98 | 98 | function UTF8CStringToUTF8String(SourceStart: PChar; SourceLen: PtrInt) : string; | |
| 99 | 99 | function UTF8Pos(const SearchForText, SearchInText: string): PtrInt; | |
| 100 | 100 | function UTF8Copy(const s: string; StartCharIndex, CharCount: PtrInt): string; | |
| 101 | 101 | procedure UTF8Delete(var s: String; StartCharIndex, CharCount: PtrInt); | |
| 102 | 102 | procedure UTF8Insert(const source: String; var s: string; StartCharIndex: PtrInt); | |
| 103 | 103 | ||
| 104 | 104 | function UTF8LowerCase(const AInStr: string; ALanguage: string=''): string; | |
| 105 | 105 | function UTF8UpperCase(const AInStr: string; ALanguage: string=''): string; | |
| 106 | 106 | function FindInvalidUTF8Character(p: PChar; Count: PtrInt; | |
| 107 | 107 | StopOnNonASCII: Boolean = false): PtrInt; | |
| 108 | 108 | function ValidUTF8String(const s: String): String; | |
| 109 | 109 | ||
| 110 | 110 | procedure AssignUTF8ListToAnsi(UTF8List, AnsiList: TStrings); | |
| 111 | 111 | ||
| 112 | 112 | //비교 함수 | |
| 113 | 113 | ||
| 114 | 114 | function UTF8CompareStr(const S1, S2: string): Integer; | |
| 115 | 115 | function UTF8CompareText(const S1, S2: string): Integer; | |
| 116 | 116 | ``` | |
| 117 | 117 | ||
| 118 | 118 | ### 디렉토리 및 파일 이름 다루기 | |
| 119 | 119 | ||
| 120 | 120 | 라자루스는 UTF-인코딩에서 파일명과 디렉토리명을 제외하고 조절 또는 동작하지만, RTL은 디렉토리 및 파일명에서는 ANSI 스트링을 사용한다. | |
| 121 | 121 | ||
| 122 | 122 | 예를 들면, TFileListBox 의 디렉토리 속성을 현재 디렉토리로 설정하는 버튼을 놓아보자. RTL 함수 [[doc:rtl/sysutils/getcurrentdir.html|GetCurrentDir]] 는 ANSI로 Unicode가 아니므로 변환이 필요하다. | |
| 123 | 123 | ||
| 124 | 124 | ``` pascal | |
| 125 | 125 | procedure TForm1.Button1Click(Sender: TObject); | |
| 126 | 126 | begin | |
| 127 | 127 | FileListBox1.Directory:=SysToUTF8(GetCurrentDir); | |
| 128 | 128 | // 또는 FileUtil 유닛의 함수를 사용하거나 | |
| 129 | 129 | FileListBox1.Directory:=GetCurrentDirUTF8; | |
| 130 | 130 | end; | |
| 131 | 131 | ``` | |
| 132 | 132 | ||
| 133 | 133 | FileUtil 유닛은 UTF-8 문자열에 관한 공통 파일들을 정의하고 있다. | |
| 134 | 134 | ||
| 135 | 135 | ``` pascal | |
| 136 | 136 | // RTL 과 유사하지만 시스템 인코딩 대신 UTF-8 로 동작하는 기본 함수들 | |
| 137 | 137 | ||
| 138 | 138 | // AnsiToUTF8 과 UTF8ToAnsi 은 Linux, BSD, Mac OS X에서는 widestring 매니저가 필요하다. | |
| 139 | 139 | // 하지만 이 OS들은 UTF-8 이 기본 시스템 인코딩이기 때문에 widestring 매니저가 필요하지는 않다. | |
| 140 | 140 | function NeedRTLAnsi: boolean;// 시스템 인코딩이 UTF-8이 아니면 true | |
| 141 | 141 | procedure SetNeedRTLAnsi(NewValue: boolean); | |
| 142 | 142 | function UTF8ToSys(const s: string): string;// UTF8ToAnsi 와 같으나 widestring 매니저에 보다 더 독립적이다 | |
| 143 | 143 | function SysToUTF8(const s: string): string;// AnsiToUTF8 과 같으나 widestring 매니저에 보다 더 독립적이다 | |
| 144 | 144 | ||
| 145 | 145 | // 파일 동작 | |
| 146 | 146 | function FileExistsUTF8(const Filename: string): boolean; | |
| 147 | 147 | function FileAgeUTF8(const FileName: string): Longint; | |
| 148 | 148 | function DirectoryExistsUTF8(const Directory: string): Boolean; | |
| 149 | 149 | function ExpandFileNameUTF8(const FileName: string): string; | |
| 150 | 150 | function ExpandUNCFileNameUTF8(const FileName: string): string; | |
| 151 | 151 | {$IFNDEF VER2_2_0} | |
| 152 | 152 | function ExtractShortPathNameUTF8(Const FileName : String) : String; | |
| 153 | 153 | {$ENDIF} | |
| 154 | 154 | function FindFirstUTF8(const Path: string; Attr: Longint; out Rslt: TSearchRec): Longint; | |
| 155 | 155 | function FindNextUTF8(var Rslt: TSearchRec): Longint; | |
| 156 | 156 | procedure FindCloseUTF8(var F: TSearchrec); | |
| 157 | 157 | function FileSetDateUTF8(const FileName: String; Age: Longint): Longint; | |
| 158 | 158 | function FileGetAttrUTF8(const FileName: String): Longint; | |
| 159 | 159 | function FileSetAttrUTF8(const Filename: String; Attr: longint): Longint; | |
| 160 | 160 | function DeleteFileUTF8(const FileName: String): Boolean; | |
| 161 | 161 | function RenameFileUTF8(const OldName, NewName: String): Boolean; | |
| 162 | 162 | function FileSearchUTF8(const Name, DirList : String): String; | |
| 163 | 163 | function FileIsReadOnlyUTF8(const FileName: String): Boolean; | |
| 164 | 164 | function GetCurrentDirUTF8: String; | |
| 165 | 165 | function SetCurrentDirUTF8(const NewDir: String): Boolean; | |
| 166 | 166 | function CreateDirUTF8(const NewDir: String): Boolean; | |
| 167 | 167 | function RemoveDirUTF8(const Dir: String): Boolean; | |
| 168 | 168 | function ForceDirectoriesUTF8(const Dir: string): Boolean; | |
| 169 | 169 | ||
| 170 | 170 | // 환경 | |
| 171 | 171 | function ParamStrUTF8(Param: Integer): string; | |
| 172 | 172 | function GetEnvironmentStringUTF8(Index : Integer): String; | |
| 173 | 173 | function GetEnvironmentVariableUTF8(const EnvVar: String): String; | |
| 174 | 174 | function GetAppConfigDirUTF8(Global: Boolean): string; | |
| 175 | 175 | ``` | |
| 176 | 176 | ||
| 177 | 177 | ### 윈도우에서 동아시아 언어 들 | |
| 178 | 178 | ||
| 179 | 179 | 윈도우즈 XP 상의 사용자 인터페이스 컨트롤의 기본 폰트 (Tahoma)는 여러 스크립트/알파벳/언어들을 정확히 표시할 수 있다. 이 언어에는 아라비아, 러시아(Cyrillic 알파벳) 과 서양 언어(라틴/그리스 알파벳)이 해당되며, 한국어, 중국어, 일본어 같은 동아시아 언어는 해당되지 않는다. | |
| 180 | 180 | ||
| 181 | 181 | 간단하게 제어판으로가서 지역 설정을 선택하고, 언어 탭을 클릭하고 동아시아 언어팩을 설치하면, 표준 사용자 인터페이스 폰트는 이 언어들을 정확히 표현할 수 있다.이러한 언어에 지역특성화 된 윈도우즈 XP 버전은 이 언어팩을 이마 설치하고 있다. 더 많은 설명은 [여기에](http://newton.uor.edu/Departments&Programs/AsianStudiesDept/Language/asianlanguageinstallation_XP.html) | |
| 182 | 182 | ||
| 183 | 183 | 이후의 윈도우즈 버전은 이 언어에 대한 지원을 하고 있다. | |
| 184 | 184 | ||
| 185 | 185 | ### UTF-8의 사용 | |
| 186 | 186 | ||
| 187 | 187 | 자세한 것은 [[UTF8 strings and characters|UTF-8 문자열과 문자를]] 보세요 | |
| 188 | 188 | ||
| 189 | 189 | ## Free Pascal Particularities | |
| 190 | 190 | ||
| 191 | 191 | ### UTF8 와 소스 파일 - the missing BOM | |
| 192 | 192 | ||
| 193 | 193 | 라자루스로 소스파일을 만들거나 비-ASCII 문자들을 사용하면 파일은 UTF-8로 저장된다. 이것은 **BOM** (Byte Order Mark)을 사용하지 **않는다**. 소스 에디터 상에서 오른쪽 마우스 클릭하여 / File Settings / Encoding 을 선택하여 인코딩을 설정할 수 있다. UTF-8이 BOM을 갖지 않는 것과는 별도로, BOM이 없는 것은 FPC 가 Ansistring을 다루는 방법 때문이다. 호환성 때문에 LCL은 Ansistring 을 사용하고 이식성 때문에 LCL은 UTF8을 사용한다. | |
| 194 | 194 | ||
| 195 | 195 | Note: 어떤 MS 윈도우즈 텍스트 에디터는 이 파일들을 시스템 코드페이지(OEM 코드페이지)로 인코드하고 부정확한 문자로 표시한다. **BOM 을 추가하면 안된다** 만약 BOM을 추가했다면 모든 문자열 할당을 변경해야만 한다. | |
| 196 | 196 | ||
| 197 | 197 | 예를 들면: | |
| 198 | 198 | ||
| 199 | 199 | ``` pascal | |
| 200 | 200 | Button1.Caption := 'Über'; | |
| 201 | 201 | ``` | |
| 202 | 202 | ||
| 203 | 203 | BOM 이 없다면 (그리고 코드페이지를 모른다면) 컴파일러는 문자열을 시스템 인코딩으로 다루고 각 바이트를 변환없이 문자열로 복사한다. 이것이 LCL이 문자열을 요구하는 방법이다. | |
| 204 | 204 | ||
| 205 | 205 | ``` pascal | |
| 206 | 206 | // 소스파일은 BOM이 없이 UTF 로 저장 | |
| 207 | 207 | if FileExists('Über.txt') then ; // 잘못 됨, FileExists 는 시스템 인코딩을 필요로 함 | |
| 208 | 208 | if FileExistsUTF8('Über.txt') then ; // 맞음 | |
| 209 | 209 | ``` | |
| 210 | 210 | ||
| 211 | 211 | ## Unicode essentials | |
| 212 | 212 | ||
| 213 | 213 | Unicode 표준은 정수 0부터 10FFFF(h) 까지 문자들에 매핑한다. 각 매핑은 코드포인트라고 부른다. 다른말로 말하면, Unicode 문자는 다른 말로 말하면 원칙적으로 코드 포인트는 U+000000 에서 U+10FFFF (0에서 1 114 111) 까지로 정의한다. | |
| 214 | 214 | ||
| 215 | 215 | Unicode 코드 포인트를 유일한 바이트 순서로 표현하는데는 세가지 방법이 있다. 이 방법들은 유니코드 변환 포맷이라고 부르다: UTF-8, UTF-16 및 UTF-32. 이들간에는 모두 변환이 가능하다. 다음에 기초적인 특성을 보여주었다. | |
| 216 | 216 | ||
| 217 | 217 | ` UTF-8 UTF-16 UTF-32`\ | |
| 218 | 218 | `가장 작은 코드 포인트 [hex] 000000 000000 000000`\ | |
| 219 | 219 | `가장 큰 토드 포인트 [hex] 10FFFF 10FFFF 10FFFF`\ | |
| 220 | 220 | `코드 단위 크기 [bits] 8 16 32`\ | |
| 221 | 221 | `문자당 최소 바이트 수 1 2 4`\ | |
| 222 | 222 | `문자당 최대 바이트 수 4 4 4` | |
| 223 | 223 | ||
| 224 | 224 | **UTF-8**은 몇가지 중요하고도 유용한 특징이 있다: 이것은 바이트의 순서로 번역 되므로 lo- 와 hi-순서 바이트라는 개념이 없다. U+000 에서 U+007E(ASCII)의 유니코드 문자는 00h에서 7Fh(아스키 호환성)로 간단히 인코드 된다. 7-비트 아스키 문자들을 가진 화일과 문자들은 아스키와 UTF-8에서 모두 같은 인코등을 갖는 다는 것을 의미한다. U+007F를 넘는 모든 문자들은 몇개 바이트의 순서로 인코딩 되어 각각은 두개의 MSB 셋트를 가지게 된다. 더 긴 바이트의 다른 문자에서는 문자의 바이트 순서가 있는 바이트를 얻을 수 있다. 이것은 부분 문자열을 쉽게 검색할 수 있도록 한다. 멀티 바이트(비-아스키 문자를 말함) 중 첫번째는 항상 C0h에서 FDh 사이이며 이것은 이 문자에 대해 얼마나 많은 바이트가 가능한지를 표시하는 것이다. 멀티바이트 순서에서 모든 다른 바이트는 80h에서 BFh 사이에 있어 쉽게 동기화할 수 있게 한다. | |
| 225 | 225 | ||
| 226 | 226 | **UTF-16** 은 다음과 같은 중요한 속성이 있다: 이는 U+0000에서 U+d7ff까지의 단일한 16-비트 워드를 인코딩에 사용하고 나머지 유니코드 문자를 인코딩하기 위해 16-비트 워드 쌍을 사용한다. | |
| 227 | 227 | ||
| 228 | 228 | 마지막으로 모든 유니코드 문자는 **UTF-32**에서 단일한 4 바이트/32-비트 유닛으로 표시할 수 있다. | |
| 229 | 229 | ||
| 230 | 230 | 더 자세히 보기: [Unicode FAQ - Basic questions](http://www.unicode.org/faq/basic_q.html), [Unicode FAQ - UTF-8, UTF-16, UTF-32 & BOM](http://www.unicode.org/faq/utf_bom.html), [Wikipedia: UTF-8](http://en.wikipedia.org/wiki/UTF-8) [1](http://en.wikipedia.org/wiki/ISO-8859) | |
| 231 | 231 | ||
| 232 | 232 | # 상세한 구현 | |
| 233 | 233 | ||
| 234 | 234 | ## 라자루스/LCL 은 보통 UTF-8만 사용한다 | |
| 235 | 235 | ||
| 236 | 236 | 라자루스 0.9.31에서 GTK1 인터페이스에서는 톡특해서 루틴에서 다른 인코딩을 사용할 수 있는 표시를 하지 않았다면, 모든 LCL 인터페이스는 Unicode가 가능하고 LCL을 사용하며 UTF-8로 인코드 된 문자열만 사용할 수 있다. | |
| 237 | 237 | ||
| 238 | 238 | ## win32 인터페이스에서 Unicode를 가능하게 하기 | |
| 239 | 239 | ||
| 240 | 240 | ### 개관 | |
| 241 | 241 | ||
| 242 | 242 | 무선 가장 중요한 것은 Win32 인터페이스로 패치된 모든 유니코드는 IFDEF WindowsUnicodeSupport 로 끝나야 ANSI 인터페이스가 깨지는 것을 피할 수 있다. 이렇게 안정화 된 후, 모든 ifdefs는 제거되면 Unicode 부분만 남게 될 것이다. 이 싯점에서 ANSI 문자를 사용하는 모든 프로그램은 Unicode로의 이전이 필요하다. | |
| 243 | 243 | ||
| 244 | 244 | ### Win9x 상에서 Unicode 미지원 | |
| 245 | 245 | ||
| 246 | 246 | Win 9x 이하의 윈도우즈 플랫폼은 ISO 코드 페이지 표준에 기초를 두었기 때문에 유니코드를 부분적으로만 지원할 뿐이다. Windows NT로 윈도우즈 플랫폼 (예, windows 200, XP, Vista, 7, 8) 및 Windows CE는 Unicode를 모두 지원한다. Win 9x 와 NT는 두가지의 API함수를 나란히 지원한다: 이전의 ANSI 가 가능한 *A 와 새로운 Unicode 가 가능한 *W. *W 함수는 wide string을 - UTF-16인코딩 문자열 - 파라메터로 받아들인다. | |
| 247 | 247 | ||
| 248 | 248 | Windows 9x 는 모든 *W 함수를 가지지만 모두 빈 함수 뿐이어서 할 수 있는 것이 없다. 단지 몇개의 *W 함수만이 9x에서 구현되어 있을 뿐이다: 이 들은 다음 섹션인 "Windows 9x에 존재하는 Wide 함수" 에 리스트하였다. 이 속성은 하나의 어플리케이션이 Win9x 와 WinNT 에서 동작할 수 있게 하며 사용할 수 있는 API셋을 실행 시에 찾을 수 있게 한다. | |
| 249 | 249 | ||
| 250 | 250 | Windows CE는 Wide API 함수만을 지원한다. | |
| 251 | 251 | ||
| 252 | 252 | ### Wide 함수들이 Windows 9x상에 존재한다 | |
| 253 | 253 | ||
| 254 | 254 | 몇몇 Wide API 함수가 윈도우즈 9x상에 존재한다. 다음에 그 함수에 관한 리스트가 있다: <http://support.microsoft.com/kb/210341> | |
| 255 | 255 | ||
| 256 | 256 | 변환 예: | |
| 257 | 257 | ||
| 258 | 258 | ``` pascal | |
| 259 | 259 | GetTextExtentPoint32(hdcNewBitmap, LPSTR(ButtonCaption), | |
| 260 | 260 | Length(ButtonCaption), TextSize); | |
| 261 | 261 | ``` | |
| 262 | 262 | ||
| 263 | 263 | 이렇게: | |
| 264 | 264 | ||
| 265 | 265 | ``` pascal | |
| 266 | 266 | {$ifdef WindowsUnicodeSupport} | |
| 267 | 267 | GetTextExtentPoint32W(hdcNewBitmap, PWideChar(Utf8Decode(ButtonCaption)), Length(WideCaption), TextSize); | |
| 268 | 268 | {$else} | |
| 269 | 269 | GetTextExtentPoint32(hdcNewBitmap, LPSTR(ButtonCaption), Length(ButtonCaption), TextSize); | |
| 270 | 270 | {$endif} | |
| 271 | 271 | ``` | |
| 272 | 272 | ||
| 273 | 273 | #### Ansi 와 Wide 버전을 필요로 하는 함수들 | |
| 274 | 274 | ||
| 275 | 275 | 첫 변환 예: | |
| 276 | 276 | ||
| 277 | 277 | ``` pascal | |
| 278 | 278 | function TGDIWindow.GetTitle: String; | |
| 279 | 279 | var | |
| 280 | 280 | l: Integer; | |
| 281 | 281 | begin | |
| 282 | 282 | l := Windows.GetWindowTextLength(Handle); | |
| 283 | 283 | SetLength(Result, l); | |
| 284 | 284 | Windows.GetWindowText(Handle, @Result[1], l); | |
| 285 | 285 | end; | |
| 286 | 286 | ``` | |
| 287 | 287 | ||
| 288 | 288 | 이렇게: | |
| 289 | 289 | ||
| 290 | 290 | ``` pascal | |
| 291 | 291 | function TGDIWindow.GetTitle: String; | |
| 292 | 292 | var | |
| 293 | 293 | l: Integer; | |
| 294 | 294 | AnsiBuffer: string; | |
| 295 | 295 | WideBuffer: WideString; | |
| 296 | 296 | begin | |
| 297 | 297 | ||
| 298 | 298 | {$ifdef WindowsUnicodeSupport} | |
| 299 | 299 | ||
| 300 | 300 | if UnicodeEnabledOS then | |
| 301 | 301 | begin | |
| 302 | 302 | l := Windows.GetWindowTextLengthW(Handle); | |
| 303 | 303 | SetLength(WideBuffer, l); | |
| 304 | 304 | l := Windows.GetWindowTextW(Handle, @WideBuffer[1], l); | |
| 305 | 305 | SetLength(WideBuffer, l); | |
| 306 | 306 | Result := Utf8Encode(WideBuffer); | |
| 307 | 307 | end | |
| 308 | 308 | else | |
| 309 | 309 | begin | |
| 310 | 310 | l := Windows.GetWindowTextLength(Handle); | |
| 311 | 311 | SetLength(AnsiBuffer, l); | |
| 312 | 312 | l := Windows.GetWindowText(Handle, @AnsiBuffer[1], l); | |
| 313 | 313 | SetLength(AnsiBuffer, l); | |
| 314 | 314 | Result := AnsiToUtf8(AnsiBuffer); | |
| 315 | 315 | end; | |
| 316 | 316 | ||
| 317 | 317 | {$else} | |
| 318 | 318 | ||
| 319 | 319 | l := Windows.GetWindowTextLength(Handle); | |
| 320 | 320 | SetLength(Result, l); | |
| 321 | 321 | Windows.GetWindowText(Handle, @Result[1], l); | |
| 322 | 322 | ||
| 323 | 323 | {$endif} | |
| 324 | 324 | ||
| 325 | 325 | end; | |
| 326 | 326 | ``` | |
| 327 | 327 | ||
| 328 | 328 | ### 스크린 샷 | |
| 329 | 329 | ||
| 330 | - | ||
| 331 | - | ||
| 332 | - | ||
| 333 | - | ||
| 330 | + | 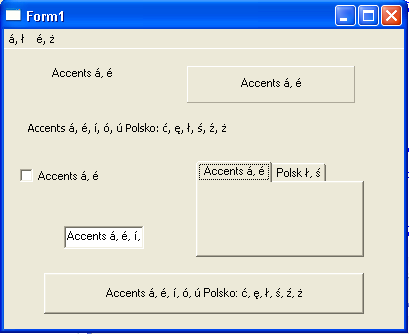 | |
| 334 | 331 | ||
| 335 | 332 | # FPC 코드 페이지 | |
| 336 | 333 | ||
| 337 | 334 | 컴파일러 (FPC)는 명령어 옵션 *-Fc*(에를 들면, *-Fcutf8*) 및 동일한 표현인 *codepage* 지시어(예, *{\$codepage utf8}*)을 소스 코드에 넣어 코드페이지를 지정하는 것을 지원한다. 이런 경우, 프로그램에서 문자열 상수를 표현하는 바이트를 문자 그대로 복사하기 보다는 컴파일러가 코드페이지에 따라 모든 문자 데이터를 해석하도록 하는 것이 좋다. | |
| 338 | 335 | ||
| 339 | 336 | 두가지 가 있다: | |
| 340 | 337 | ||
| 341 | 338 | - 유닉스 플랫폼에서, uses 절에 *swstring*을 추가하여 widestring 매니저를 포함했는지 확인하고, 없다면 프로그램은 실행시 모든 문자 데이터를 정확히 변환할 수 없을 것이다. 유닛이 프로그램이 libc에 종속되게 했을 것이기 때문에 이것이 디폴트는 아니어서 크로스-컴파일을 어렵게 한다. | |
| 342 | 339 | - 컴파일러는 비-아스키 문자를 가진 모든 문자열 상수를 widesring 상수로 변환한다. 이는 자동적을 ansistring으로 변환된다(컴파일시 혹은 실행시), 하지만 이는 두 문자를 합치거나 단일 문자열 상수에 ordinal 값이 있다면 경고를 보여 준다: | |
| 343 | 340 | ||
| 344 | 341 | 예를 들면: | |
| 345 | 342 | ||
| 346 | 343 | ``` pascal | |
| 347 | 344 | program project1; | |
| 348 | 345 | {$codepage utf8} | |
| 349 | 346 | {$mode objfpc}{$H+} | |
| 350 | 347 | {$ifdef unix} | |
| 351 | 348 | uses cwstring; | |
| 352 | 349 | {$endif} | |
| 353 | 350 | var | |
| 354 | 351 | a,b,c: string; | |
| 355 | 352 | begin | |
| 356 | 353 | a:='ä'; | |
| 357 | 354 | b:='='#$C3#$A4; // #$C3#$A4 is UTF-8 for ä | |
| 358 | 355 | c:='ä='#$C3#$A4; | |
| 359 | 356 | writeln(a,b); // writes ä=ä | |
| 360 | 357 | writeln(c); // writes ä=ä | |
| 361 | 358 | end. | |
| 362 | 359 | ``` | |
| 363 | 360 | ||
| 364 | 361 | 컴파일하고 실행하면, 이렇게 쓸 것이다: | |
| 365 | 362 | ||
| 366 | 363 | ä=ä | |
| 367 | 364 | ä=ä | |
| 368 | 365 | ||
| 369 | 366 | 이유는 *ä* 이 나타나 위에 언급한 대로 'c'에 해당하는 상수 문자열의 나머지 부분이 widestring으로 분류 되기 때문이다. 결과적으로 \#\$C3 와 \#\$A4 는 ansichar 대신 widechar(#\$C3) 와 widechar(#\$A4) 로 해석된다. | |
| 370 | 367 | ||
| 371 | 368 | # 더 보기 | |
| 372 | 369 | ||
| 373 | 370 | - [[Character and string types|문자와 문자열 타입]] | |
| 374 | 371 | - [[UTF-8]] - UTF-8 문자열 설명 | |
| 375 | 372 | - [[FPC Unicode support|FPC 유니코드 지원]] | |
| 376 | 373 | - [[for-in loop|for-in_loop#Traversing_UTF-8_strings]] - UTF8문자열을 통달하는 방법을 보여주는 코드 | |
| 377 | 374 | - [[unicode use cases|유니코드 사용 예]] | |
| 378 | 375 | ||
| 379 | 376 | --- | |
| 380 | 377 | *From the Free Pascal wiki, page "LCL Unicode Support/ko", as it stood on 2020-02-19 after a change by Trev, out of the wiki's dump of 2024-05-26. Copyright stays with the author who wrote it, according to the old wiki's [[Licensing]] page. If you have concerns about this material, [message the admin](/wiki-contact).* |