

LCL Unicode Support/fr: what changed
Revision 2 to 3. Removed lines have a minus sign; added lines have a plus sign.
| Old | New | Line | |
|---|---|---|---|
| 1 | 1 | ## Introduction | |
| 2 | 2 | ||
| 3 | 3 | A partir de la version 0.9.25, Lazarus supporte pleinement Unicode pour toutes les plateformes, excepté Gtk 1. Cette page couvre l'Unicode dans Lazarus jusqu'à la version 1.4 qui utilise FPC 2.6.4 | |
| 4 | 4 | ||
| 5 | 5 | Ayant commmençé avec la version 2.0, Lazarus aura amélioré le support Unicode en utilisant les caractéristiques de FPC 3.0+. Voir les détails ici: [[Unicode Support in Lazarus]] | |
| 6 | 6 | ||
| 7 | 7 | ## Instructions pour les utilisateurs | |
| 8 | 8 | ||
| 9 | 9 | Même si Lazarus possède des ensembles de widgets Unicode, il est important de noter que tout n'est pas en Unicode. Il est de la responsabilité du développeur de connaître l'encodage de ses chaînes de caractère, et d'effectuer la conversion appropriée entre les bibliothèques qui attendent des encodages différents. | |
| 10 | 10 | ||
| 11 | 11 | Habituellement, l'encodage est défini bibliothèque par bibliothèque (une bibliothèque dynamique (dll) ou un package Lazarus). Chaque bibliothèque attendra uniformément un type d'encodage, qui sera habituellement soit Unicode (UTF-8 pour Lazarus), soit ANSI (qui signifie l'encodage du système, et peut être UTF-8 ou non). La RTL et la FCL de FPC \<= 2.6 attendent des chaînes ANSI. | |
| 12 | 12 | ||
| 13 | 13 | Vous pouvez convertir entre Unicode et ANSI en utilisant | |
| 14 | 14 | ||
| 15 | 15 | - les fonctions **UTF8ToAnsi** et **AnsiToUTF8** de l'unité System (de FPC), | |
| 16 | 16 | - ou les fonctions **UTF8ToSys** et **SysToUTF8** de l'unité FileUtil (de Lazarus). | |
| 17 | 17 | ||
| 18 | 18 | Les deux dernières sont plus intelligentes (plus rapides) mais engendrent plus de code dans votre programme. | |
| 19 | 19 | ||
| 20 | 20 | ### FPC ne travaille pas en Unicode | |
| 21 | 21 | ||
| 22 | 22 | Le Runtime Free Pascal (RTL), et la bibliothèque de composants Free Pascal (FCL), dans les versions actuelles de FPC (jusqu'à la 2.6.x) sont ANSI, vous devrez donc convertir les chaines venant des bibliothèques Unicode, ou allant vers des bibliothèques Unicode (comme la LCL).\ | |
| 23 | 23 | Il y a des améliorations significatives dans les branches de développement FPC 2.7.1 en ce qui concerne les chaînes. Voir RawByteString et UTF8String dans [[FPC Unicode support]]. | |
| 24 | 24 | ||
| 25 | 25 | ### Convertir entre ANSI et Unicode | |
| 26 | 26 | ||
| 27 | 27 | > **Note:** AnsiToUTF8 et UTF8ToAnsi nécessitent un gestionnaire de widestring sous Linux, BSD et Mac OS X. Vous pouvez utiliser les fonctions SysToUTF8 et UTF8ToSys (unité FileUtil) ou ajouter le gestionnaire de widestring en ajoutant cwstring comme l'une des première unités dans la section uses de votre programme. | |
| 28 | 28 | ||
| 29 | 29 | Exemples: | |
| 30 | 30 | ||
| 31 | 31 | Disons que vous récupérez une chaine d'un TEdit et que vous voulez la passer à une fonction de fichier de la RTL : | |
| 32 | 32 | ||
| 33 | 33 | ``` pascal | |
| 34 | 34 | var | |
| 35 | 35 | MyString: string; // Encodé en utf-8 | |
| 36 | 36 | begin | |
| 37 | 37 | MyString := MyTEdit.Text; | |
| 38 | 38 | SomeRTLRoutine(UTF8ToAnsi(MyString)); | |
| 39 | 39 | end; | |
| 40 | 40 | ``` | |
| 41 | 41 | ||
| 42 | 42 | Et pour le sens inverse : | |
| 43 | 43 | ||
| 44 | 44 | ``` pascal | |
| 45 | 45 | var | |
| 46 | 46 | MyString: string; // Encodé en ANSI | |
| 47 | 47 | begin | |
| 48 | 48 | MyString := SomeRTLRoutine; | |
| 49 | 49 | MyTEdit.Text := AnsiToUTF8(MyString); | |
| 50 | 50 | end; | |
| 51 | 51 | ``` | |
| 52 | 52 | ||
| 53 | 53 | **Important**: UTF8ToAnsi retournera une chaine vide si la chaine UTF8 contient des caractères invalides. | |
| 54 | 54 | ||
| 55 | 55 | ### Widestrings et Ansistrings | |
| 56 | 56 | ||
| 57 | 57 | Une widestring est un type de chaine dont les éléments ont une taille de 2 octets. Les widestrings stockent pratiquement toujours leurs données dans l'encodage UTF-16. Voir [[Widestrings/fr|Widestrings]] | |
| 58 | 58 | ||
| 59 | 59 | Notez que chaque point de donnée accédé à la manière d'un tableau sur une widestring tient sur 2 octets. En UTF-16, un caractère peut utiliser 1 ou 2 points de données, et occupe donc 2 ou 4 octets. Cela signifie qu'acccéder à une widestring en tant que tableau et espérer obtenir un caractère UTF-16 est **complètement faux** et échouera lorsqu'un caractère sur 4 octets est présent dans la chaine. Notez également que UTF-16, comme UTF-8, peut avoir des caractères composés. Le caractère "Á" par exemple peut être encodé soit comme un seul caractère, soit comme 2 caractères : "A" + un modificateur d'accent. Donc en Unicode, un texte qui contient des caractères accentués peut souvent être encodé de plusieurs façons, et ni Lazarus ni FPC gèrent ça automatiquement. | |
| 60 | 60 | ||
| 61 | 61 | Quand vous passez de Ansistrings à Widestrings, vous devez convertir l'encodage. | |
| 62 | 62 | ||
| 63 | 63 | ``` pascal | |
| 64 | 64 | var | |
| 65 | 65 | w: widestring; | |
| 66 | 66 | begin | |
| 67 | 67 | w:='Über'; // Faux, car FPC convertira la page de code système vers UTF16 | |
| 68 | 68 | w:=UTF8ToUTF16('Über'); // correct | |
| 69 | 69 | Button1.Caption:=UTF16ToUTF8(w); | |
| 70 | 70 | end; | |
| 71 | 71 | ``` | |
| 72 | 72 | ||
| 73 | 73 | ### Caractères et chaînes UTF8 | |
| 74 | 74 | ||
| 75 | 75 | (NDT : une fois la page UnfUTF8_strings_and_characters traduite, il faut aligner ce paragraphe et ses s/paragraphes sur la version anglaise) | |
| 76 | 76 | ||
| 77 | 77 | Jusqu'à Lazarus 0.9.30, les routines de gestion de l'UTF-8 étaient dans la LCL dans l'unité LCLProc. Dans Lazarus 0.9.31 (et supérieur), les routines de LCLProc sont toujours disponibles pour la compatibilité ascendante, mais le vrai code qui gère UTF-8 est localisé dans le package lazutils, dans l'unité lazutf8. | |
| 78 | 78 | ||
| 79 | 79 | Pour exécuter des opérations sur des chaines UTF-8, il est préférable d'utiliser les routines de l'unité lazutf8 plutôt que celles de SysUtils de Free Pascal, car SysUtils n'est pas encore prêt à travailler avec Unicode, alors que lazutf8 l'est. Substituez simplement les routines de SysUtils avec leur équivalent lazutf8, qui ont toujours le même nom exception faite du préfixe "UTF8" ajouté. | |
| 80 | 80 | ||
| 81 | 81 | Notez également que simplement itérer sur les caractères comme si la chaine était un tableau ne fonctionne pas en Unicode. Ceci n'est pas quelque chose de spécifique à UTF-8 et vous ne pouvez simplement pas supposer qu'un caractère aura une taille fixe en Unicode. Si vous voulez itéré sur les caractères d'une chaine UFT-8, il y a basiquement deux moyens : | |
| 82 | 82 | ||
| 83 | 83 | - itérer sur les octets - utile pour chercher une sous chaine ou quand vous ne vous intéressez qu'aux caractères ASCII de la chaine UTF8. Par exemple pour analyser (parser) des fichier xml. | |
| 84 | 84 | - itérer sur les caractères - utile pour les composants graphiques tel synedit. Par exemple lorsque vous souhaitez connaître le troisième caractère affiché à l'écran. | |
| 85 | 85 | ||
| 86 | 86 | #### Rechercher une sous chaine | |
| 87 | 87 | ||
| 88 | 88 | Du fait de la nature particulière d'UTF8, vous pouvez simplement utiliser les fonctions de manipulations de chaine classiques. Même si UTF-8 est un encodage multi-octets, le premier octet (d'un caractère multi-octets) ne peut pas être pris pour les suivants. Donc chercher une chaine UTF-8 valide avec Pos retournera toujours une position UTF-8 valide : | |
| 89 | 89 | ||
| 90 | 90 | ``` pascal | |
| 91 | 91 | uses lazutf8; // LCLProc for Lazarus 0.9.30 or inferior | |
| 92 | 92 | ... | |
| 93 | 93 | procedure Where(SearchFor, aText: string); | |
| 94 | 94 | var | |
| 95 | 95 | BytePos: LongInt; | |
| 96 | 96 | CharacterPos: LongInt; | |
| 97 | 97 | begin | |
| 98 | 98 | BytePos:=Pos(SearchFor,aText); | |
| 99 | 99 | CharacterPos:=UTF8Length(PChar(aText),BytePos-1); | |
| 100 | 100 | writeln('The substring "',SearchFor,'" is in the text "',aText,'"', | |
| 101 | 101 | ' at byte position ',BytePos,' and at character position ',CharacterPos); | |
| 102 | 102 | end; | |
| 103 | 103 | ``` | |
| 104 | 104 | ||
| 105 | 105 | Du fait de l’ambiguïté d'Unicode, Pos() (comme n'importe quelle comparaison) peut montrer un comportement inattendu, quand par exemple l'une des chaines contient des caractères composés, alors que l'autre utilise le code direct pour la même lettre. Ceci n'est pas automatiquement géré par la RTL. | |
| 106 | 106 | ||
| 107 | 107 | #### Accéder aux caractères UTF8 | |
| 108 | 108 | ||
| 109 | 109 | Les caractères Unicode peuvent varier en longueur, donc la meilleure solution pour y accéder lorsque vous avez l'intention de le faire dans l'ordre dans lequel ils sont consiste à utiliser une itération. Pour itérer les caractères, utilisez ce code : | |
| 110 | 110 | ||
| 111 | 111 | ``` pascal | |
| 112 | 112 | uses lazutf8; // LCLProc for Lazarus 0.9.30 or inferior | |
| 113 | 113 | ... | |
| 114 | 114 | procedure DoSomethingWithString(AnUTF8String: string); | |
| 115 | 115 | var | |
| 116 | 116 | p: PChar; | |
| 117 | 117 | CharLen: integer; | |
| 118 | 118 | FirstByte, SecondByte, ThirdByte: Char; | |
| 119 | 119 | begin | |
| 120 | 120 | p:=PChar(AnUTF8String); | |
| 121 | 121 | repeat | |
| 122 | 122 | CharLen := UTF8CharacterLength(p); | |
| 123 | 123 | ||
| 124 | 124 | // here you have a pointer to the char and it's length | |
| 125 | 125 | // You can access the bytes of the UTF-8 Char like this: | |
| 126 | 126 | if CharLen >= 1 then FirstByte := P[0]; | |
| 127 | 127 | if CharLen >= 2 then SecondByte := P[1]; | |
| 128 | 128 | if CharLen >= 3 then ThirdByte := P[2]; | |
| 129 | 129 | ||
| 130 | 130 | inc(p,CharLen); | |
| 131 | 131 | until (CharLen=0) or (p^ = #0); | |
| 132 | 132 | end; | |
| 133 | 133 | ``` | |
| 134 | 134 | ||
| 135 | 135 | #### Accéder au Nième caractère UTF8 | |
| 136 | 136 | ||
| 137 | 137 | Vous pouvez également vouloir effectuer un accès direct aux caractères UTF-8. | |
| 138 | 138 | ||
| 139 | 139 | ``` pascal | |
| 140 | 140 | uses lazutf8; // LCLProc for Lazarus 0.9.30 or inferior | |
| 141 | 141 | ... | |
| 142 | 142 | var | |
| 143 | 143 | AnUTF8String, NthChar: string; | |
| 144 | 144 | begin | |
| 145 | 145 | NthChar := UTF8Copy(AnUTF8String, N, 1); | |
| 146 | 146 | ``` | |
| 147 | 147 | ||
| 148 | 148 | #### Itérer les points de code en utilisant UTF8CharacterToUnicode | |
| 149 | 149 | ||
| 150 | 150 | Ce qui suit montre comment itérer les valeurs des points de code 32bits de chacun des caractères dans une chaine UTF-8: | |
| 151 | 151 | ||
| 152 | 152 | ``` pascal | |
| 153 | 153 | uses lazutf8; // LCLProc for Lazarus 0.9.30 or inferior | |
| 154 | 154 | ... | |
| 155 | 155 | procedure IterateUTF8Characters(const AnUTF8String: string); | |
| 156 | 156 | var | |
| 157 | 157 | p: PChar; | |
| 158 | 158 | unicode: Cardinal; | |
| 159 | 159 | CharLen: integer; | |
| 160 | 160 | begin | |
| 161 | 161 | p:=PChar(AnUTF8String); | |
| 162 | 162 | repeat | |
| 163 | 163 | unicode:=UTF8CharacterToUnicode(p,CharLen); | |
| 164 | 164 | writeln('Unicode=',unicode); | |
| 165 | 165 | inc(p,CharLen); | |
| 166 | 166 | until (CharLen=0) or (unicode=0); | |
| 167 | 167 | end; | |
| 168 | 168 | ``` | |
| 169 | 169 | ||
| 170 | 170 | #### Copie, longueur, mise en minuscule, etc des chaines UTF-8 | |
| 171 | 171 | ||
| 172 | 172 | Quasiment toutes les opérations que vous pouvez vouloir exécuter avec les chaines UTF-8 sont couvertes par les routines de l'unité lazutf8 (unité LCLProc pour Lazarus 0.9.30 ou inférieur). Regardez la liste suivante de routines prises de lazutf8.pas: | |
| 173 | 173 | ||
| 174 | 174 | ``` pascal | |
| 175 | 175 | function UTF8CharacterLength(p: PChar): integer; | |
| 176 | 176 | function UTF8Length(const s: string): PtrInt; | |
| 177 | 177 | function UTF8Length(p: PChar; ByteCount: PtrInt): PtrInt; | |
| 178 | 178 | function UTF8CharacterToUnicode(p: PChar; out CharLen: integer): Cardinal; | |
| 179 | 179 | function UnicodeToUTF8(u: cardinal; Buf: PChar): integer; inline; | |
| 180 | 180 | function UnicodeToUTF8SkipErrors(u: cardinal; Buf: PChar): integer; | |
| 181 | 181 | function UnicodeToUTF8(u: cardinal): shortstring; inline; | |
| 182 | 182 | function UTF8ToDoubleByteString(const s: string): string; | |
| 183 | 183 | function UTF8ToDoubleByte(UTF8Str: PChar; Len: PtrInt; DBStr: PByte): PtrInt; | |
| 184 | 184 | function UTF8FindNearestCharStart(UTF8Str: PChar; Len: integer; | |
| 185 | 185 | BytePos: integer): integer; | |
| 186 | 186 | // find the n-th UTF8 character, ignoring BIDI | |
| 187 | 187 | function UTF8CharStart(UTF8Str: PChar; Len, CharIndex: PtrInt): PChar; | |
| 188 | 188 | // find the byte index of the n-th UTF8 character, ignoring BIDI (byte len of substr) | |
| 189 | 189 | function UTF8CharToByteIndex(UTF8Str: PChar; Len, CharIndex: PtrInt): PtrInt; | |
| 190 | 190 | procedure UTF8FixBroken(P: PChar); | |
| 191 | 191 | function UTF8CharacterStrictLength(P: PChar): integer; | |
| 192 | 192 | function UTF8CStringToUTF8String(SourceStart: PChar; SourceLen: PtrInt) : string; | |
| 193 | 193 | function UTF8Pos(const SearchForText, SearchInText: string): PtrInt; | |
| 194 | 194 | function UTF8Copy(const s: string; StartCharIndex, CharCount: PtrInt): string; | |
| 195 | 195 | procedure UTF8Delete(var s: String; StartCharIndex, CharCount: PtrInt); | |
| 196 | 196 | procedure UTF8Insert(const source: String; var s: string; StartCharIndex: PtrInt); | |
| 197 | 197 | ||
| 198 | 198 | function UTF8LowerCase(const AInStr: string; ALanguage: string=''): string; | |
| 199 | 199 | function UTF8UpperCase(const AInStr: string; ALanguage: string=''): string; | |
| 200 | 200 | function FindInvalidUTF8Character(p: PChar; Count: PtrInt; | |
| 201 | 201 | StopOnNonASCII: Boolean = false): PtrInt; | |
| 202 | 202 | function ValidUTF8String(const s: String): String; | |
| 203 | 203 | ||
| 204 | 204 | procedure AssignUTF8ListToAnsi(UTF8List, AnsiList: TStrings); | |
| 205 | 205 | ||
| 206 | 206 | //compare functions | |
| 207 | 207 | ||
| 208 | 208 | function UTF8CompareStr(const S1, S2: string): Integer; | |
| 209 | 209 | function UTF8CompareText(const S1, S2: string): Integer; | |
| 210 | 210 | ``` | |
| 211 | 211 | ||
| 212 | 212 | ### Travailler avec les répertoires et les noms de fichier | |
| 213 | 213 | ||
| 214 | 214 | Les contrôles et fonctions de Lazarus attendent des noms de fichier et de répertoire encodés en utf-8, mais la RTL utilise des chaines ansi pour ces noms de fichier et répertoire. | |
| 215 | 215 | ||
| 216 | 216 | Par exemple, considérez un bouton, qui positionne la propriété Directory d'une TFileListBox au répertoire courant. La fonction RTL [[doc:rtl/sysutils/getcurrentdir.html|GetCurrentDir]] travaille en ansi, et non en unicode, donc une conversion est nécessaire: | |
| 217 | 217 | ||
| 218 | 218 | ``` pascal | |
| 219 | 219 | procedure TForm1.Button1Click(Sender: TObject); | |
| 220 | 220 | begin | |
| 221 | 221 | FileListBox1.Directory:=SysToUTF8(GetCurrentDir); | |
| 222 | 222 | // or use the functions from the FileUtil unit | |
| 223 | 223 | FileListBox1.Directory:=GetCurrentDirUTF8; | |
| 224 | 224 | end; | |
| 225 | 225 | ``` | |
| 226 | 226 | ||
| 227 | 227 | L'unité FileUtil définit les fonctions classiques de fichiers travaillant avec des chaines UTF-8: | |
| 228 | 228 | ||
| 229 | 229 | ``` pascal | |
| 230 | 230 | // basic functions similar to the RTL but working with UTF-8 instead of the | |
| 231 | 231 | // system encoding | |
| 232 | 232 | ||
| 233 | 233 | // AnsiToUTF8 and UTF8ToAnsi need a widestring manager under Linux, BSD, Mac OS X | |
| 234 | 234 | // but normally these OS use UTF-8 as system encoding so the widestringmanager | |
| 235 | 235 | // is not needed. | |
| 236 | 236 | function NeedRTLAnsi: boolean;// true if system encoding is not UTF-8 | |
| 237 | 237 | procedure SetNeedRTLAnsi(NewValue: boolean); | |
| 238 | 238 | function UTF8ToSys(const s: string): string;// as UTF8ToAnsi but more independent of widestringmanager | |
| 239 | 239 | function SysToUTF8(const s: string): string;// as AnsiToUTF8 but more independent of widestringmanager | |
| 240 | 240 | ||
| 241 | 241 | // file operations | |
| 242 | 242 | function FileExistsUTF8(const Filename: string): boolean; | |
| 243 | 243 | function FileAgeUTF8(const FileName: string): Longint; | |
| 244 | 244 | function DirectoryExistsUTF8(const Directory: string): Boolean; | |
| 245 | 245 | function ExpandFileNameUTF8(const FileName: string): string; | |
| 246 | 246 | function ExpandUNCFileNameUTF8(const FileName: string): string; | |
| 247 | 247 | {$IFNDEF VER2_2_0} | |
| 248 | 248 | function ExtractShortPathNameUTF8(Const FileName : String) : String; | |
| 249 | 249 | {$ENDIF} | |
| 250 | 250 | function FindFirstUTF8(const Path: string; Attr: Longint; out Rslt: TSearchRec): Longint; | |
| 251 | 251 | function FindNextUTF8(var Rslt: TSearchRec): Longint; | |
| 252 | 252 | procedure FindCloseUTF8(var F: TSearchrec); | |
| 253 | 253 | function FileSetDateUTF8(const FileName: String; Age: Longint): Longint; | |
| 254 | 254 | function FileGetAttrUTF8(const FileName: String): Longint; | |
| 255 | 255 | function FileSetAttrUTF8(const Filename: String; Attr: longint): Longint; | |
| 256 | 256 | function DeleteFileUTF8(const FileName: String): Boolean; | |
| 257 | 257 | function RenameFileUTF8(const OldName, NewName: String): Boolean; | |
| 258 | 258 | function FileSearchUTF8(const Name, DirList : String): String; | |
| 259 | 259 | function FileIsReadOnlyUTF8(const FileName: String): Boolean; | |
| 260 | 260 | function GetCurrentDirUTF8: String; | |
| 261 | 261 | function SetCurrentDirUTF8(const NewDir: String): Boolean; | |
| 262 | 262 | function CreateDirUTF8(const NewDir: String): Boolean; | |
| 263 | 263 | function RemoveDirUTF8(const Dir: String): Boolean; | |
| 264 | 264 | function ForceDirectoriesUTF8(const Dir: string): Boolean; | |
| 265 | 265 | ||
| 266 | 266 | // environment | |
| 267 | 267 | function ParamStrUTF8(Param: Integer): string; | |
| 268 | 268 | function GetEnvironmentStringUTF8(Index : Integer): String; | |
| 269 | 269 | function GetEnvironmentVariableUTF8(const EnvVar: String): String; | |
| 270 | 270 | function GetAppConfigDirUTF8(Global: Boolean): string; | |
| 271 | 271 | ``` | |
| 272 | 272 | ||
| 273 | 273 | #### Mac OS X | |
| 274 | 274 | ||
| 275 | 275 | (NDT : A reporter dans UTF8_strings_and_characters une fois traduite) | |
| 276 | 276 | ||
| 277 | 277 | Les fonctions de fichier de l'unité FileUtil font également attention à une particularité de Mac OS X: OS X normalise les noms de fichier. Par exemple, le nom de fichier 'ä.txt' peut être encodé en unicode avec deux séquences différentes (#\$C3#\$A4 et 'a'#\$CC#\$88). Sous Linux et BSD, vous pouvez utiliser les deux représentations. OS X convertit automatiquement le a tréma dans la séquence de trois octets. Ce qui signifie: | |
| 278 | 278 | ||
| 279 | 279 | ``` pascal | |
| 280 | 280 | if Filename1 = Filename2 then ... // n'est pas suffisant sous OS X | |
| 281 | 281 | if AnsiCompareFileName(Filename1, Filename2) = 0 then ... // insuffisant sous fpc 2.2.2, même avec cwstring | |
| 282 | 282 | if CompareFilenames(Filename1, Filename2) = 0 then ... // Ceci fonctionne toujours (unité FileUtil ou FileProcs) | |
| 283 | 283 | ``` | |
| 284 | 284 | ||
| 285 | 285 | ### Langages Est-asiatiques sous Windows | |
| 286 | 286 | ||
| 287 | 287 | La police par défaut (Tahoma) utilisée pour les contrôles d'interface utilisateur sous Windows XP est capable d'afficher correctement plusieurs langages, incluant l'arable, le russe et les langages occidentaux, mais pas les langages d'Asis de l'est, comme le chinois, le japonais et le koréen. En allant dans le Panneau de Configuration, dans les Options régionales, sur l'onglet Langages et en installant le East Asia Language Pack, la police standard de l'interface utilisateur commencera simplement à afficher correctement ces langages. Bien évidemment, les versions de Windows XP localisées pour ces langages contiendront déjà ce pack de langage. Instructions détaillées [ici](http://newton.uor.edu/Departments&Programs/AsianStudiesDept/Language/asianlanguageinstallation_XP.html). | |
| 288 | 288 | ||
| 289 | 289 | Il est supposé que les versions ultérieures de Windows ont un support direct (out-of-the-box) pour ces langages. | |
| 290 | 290 | ||
| 291 | 291 | ### Usage of UTF-8 | |
| 292 | 292 | ||
| 293 | 293 | Voir les détails dans [[UTF8 strings and characters]] | |
| 294 | 294 | ||
| 295 | 295 | ## Particularités de Free Pascal | |
| 296 | 296 | ||
| 297 | 297 | ### UTF8 et les fichiers sources - le BOM manquant | |
| 298 | 298 | ||
| 299 | 299 | Quand vous créez des fichiers source avec Lazarus et que vous saisissez des caractères non ascii, le fichier est sauvegardé en UTF-8. Il n**'utilise pas de BOM** (Byte Order Mark). Vous pouvez changer l'encodage via un clic droit dans source editor / File Settings / Encoding. La raison de l'absence de ce BOM vient de comment FPC traite les Ansistrings. Pour la compatibilité, la LCL utilise des Ansistrings, et pour la portabilité, la LCL utilise UTF8. | |
| 300 | 300 | ||
| 301 | 301 | Note: Certains éditeurs de texte windows peuvent interpréter les fichiers comme étant dans l'encodage système et les afficher avec des caractères invalides. N'ajoutez pas le BOM. Si vous ajoutez le BOM, vous devrez changer toutes les assignations de chaine. Par exemple: | |
| 302 | 302 | ||
| 303 | 303 | ``` pascal | |
| 304 | 304 | Button1.Caption := 'Über'; | |
| 305 | 305 | ``` | |
| 306 | 306 | ||
| 307 | 307 | Quand aucun BOM n'est présent (et aucun paramètre de codepage n'est passé), le compilateur considère la chaine comme étant dans l'encodage du système et copie chaque octet dans la chaine sans le convertir. C'est ainsi que la LCL attend les chaines. | |
| 308 | 308 | ||
| 309 | 309 | ``` pascal | |
| 310 | 310 | // source file saved as UTF without BOM | |
| 311 | 311 | if FileExists('Über.txt') then ; // wrong, because FileExists expects system encoding | |
| 312 | 312 | if FileExistsUTF8('Über.txt') then ; // correct | |
| 313 | 313 | ``` | |
| 314 | 314 | ||
| 315 | 315 | ## L'essentiel d'Unicode | |
| 316 | 316 | ||
| 317 | 317 | Le standard Unicode fait correspondre les entiers de 0 à 10FFFF(h) à des caractères. Chaque correspondance individuelle est appelée un point de code. En d'autres termes, les caractères Unicode sont en principe définis pour les points de codes de U+000000 à U+10FFFF (0 à 1 114 111). | |
| 318 | 318 | ||
| 319 | 319 | Il existe trois schémas pour représenter les points de code Unicode en séquences d'octets uniques. Ces schémas sont appelés formats de transformation Unicode : UTF-8, UTF-16 et UTF-32. Les conversions entre chacun d'eux sont possible. Voici leur propriétés basiques: | |
| 320 | 320 | ||
| 321 | - | ||
| 322 | - | ||
| 323 | - | ||
| 324 | - | ||
| 325 | - | ||
| 326 | - | ||
| 321 | + | ```text | |
| 322 | + | UTF-8 UTF-16 UTF-32 | |
| 323 | + | Plus petit point de code [hex] 000000 000000 000000 | |
| 324 | + | Plus grand point de code [hex] 10FFFF 10FFFF 10FFFF | |
| 325 | + | Taille unitaire de code [bits] 8 16 32 | |
| 326 | + | Octets minimum/caractère 1 2 4 | |
| 327 | + | Octets maximum/caractère 4 4 4 | |
| 328 | + | ``` | |
| 327 | 329 | ||
| 328 | 330 | **UTF-8** a plusieurs propriétés importantes et utiles: Il est interprété comme une séquence d'octets, entrainant que le concept d'octet de poids fort ou faible n'existe pas. Les caractères Unicode de U+0000 à U+007F (ASCII) sont simplement encodés comme des octets de 00h à 7Fh (compatibilité ASCII). Cela signifie que les noms de fichier et les chaines de caractères qui ne contiennent que des caractères ASCII 7 bits ont le même encodage en ASCII et en UTF-8. Tous les caractères \>U+007F sont encodés dans une séquence de plusieurs octets, pour chacun desquels les deux bits de poids forts sont positionnés. Aucune séquence d'octet d'un caractère n'est contenue à l'intérieur d'une séquence plus longue d'un autre caractère. Ceci permet des recherches faciles pour les sous chaine. Le premier octet d'une séquence multioctets qui représente un caractère non ASCII est toujours dans la plage C0h à FDh et il indique combien d'octets suivent pour ce caractère. Tous les octest suivant dans la séquence multioctet sont dans la plage 80h à BFh. Ceci permet facilement la resynchronisation et la robustesse. | |
| 329 | 331 | ||
| 330 | 332 | **UTF-16** possède la propriété la plus importante suivante: il utilise un simple mot de 16 bits pour encoder les caractères de U+0000 à U+d7ff, et une paire de mots de 16 bits chacun pour encoder n'importe quel autre caractère Unicode. | |
| 331 | 333 | ||
| 332 | 334 | Pour finir, chaque caractère Unicode peut être représenté comme un simple mot de 32 bits en **UTF-32**. | |
| 333 | 335 | ||
| 334 | 336 | Pour plus d'informations, voir: [Unicode FAQ - Questions basiques](http://www.unicode.org/faq/basic_q.html), [Unicode FAQ - UTF-8, UTF-16, UTF-32 & BOM](http://www.unicode.org/faq/utf_bom.html), [Wikipedia: UTF-8](http://en.wikipedia.org/wiki/UTF-8) [1](http://en.wikipedia.org/wiki/ISO-8859) | |
| 335 | 337 | ||
| 336 | 338 | # Détails d'implementation | |
| 337 | 339 | ||
| 338 | 340 | ## Lazarus/LCL utilisent généralement uniquement UTF-8 | |
| 339 | 341 | ||
| 340 | 342 | Depuis que l'interface gtk1 a été rendue obsolète dans Lazarus 0.9.31, toutes les interfaces LCL peuvent gérer Unicode, et la LCL utilise et accepte seulement des chaînes encodées en UTF-8, sauf pour les routines explicitement marquées comme acceptant d'autres encodages. | |
| 341 | 343 | ||
| 342 | 344 | ## Activer Unicode pour l'interface win32 | |
| 343 | 345 | ||
| 344 | 346 | #### Vue d'ensemble | |
| 345 | 347 | ||
| 346 | 348 | Premièrement, et le plus important, tous les patches Unicode pour l'interface Win32 doivent être inclus dans des IFDEF WindowsUnicodeSupport, pour éviter de casser l'interface ANSI existante. Une fois que ce sera stabilisé, tous les ifdefs seront supprimés et seule la partie Unicode restera. A ce moment tous les programmes existants qui utilisent des caractères ANSI nécessiteront une migration vers Unicode. | |
| 347 | 349 | ||
| 348 | 350 | #### Pas de support d'Unicode sur Win9x | |
| 349 | 351 | ||
| 350 | 352 | Les plateformes Windows \<=Win9x sont basées sur des code page standard ISO et supportent seulement partiellement Unicode. Les plateformes Windows à partir de Windows NT (c'est-à-dire Windows 2000, XP, Vista, 7, 8) et Windows CE supportent pleinement Unicode. | |
| 351 | 353 | ||
| 352 | 354 | Win 9x et NT offrent deux ensembles parallèles d'API : les anciennes ANSI *A et les nouvelles Unicode *W. Les fonctions *W acceptent les widestrings - encodées en UTF-16- comme paramètres. | |
| 353 | 355 | ||
| 354 | 356 | Les Windows 9x possèdent toutes les fonctions *W mais la plupart ont des implémentations vides, donc elle ne font rien. Seules certaines fonctions *W sont pleinement implémentées sous Windows 9x. Elles sont listées ci-dessous dans la section "Fonctions Wide présentes sur Windows 9x". Cette propriété est importante car elle permet d'avoir une seule application à la fois pour Win9x et WinNT, et détecter au runtime quel ensemble d'API utiliser. | |
| 355 | 357 | ||
| 356 | 358 | Windows CE utilise uniquement les API Wide. | |
| 357 | 359 | ||
| 358 | 360 | #### Fonctions Wide présentes sur Windows 9x | |
| 359 | 361 | ||
| 360 | 362 | Certaines fonctions des API Wide sont présentes sur Windows 9x. Vous trouverez ici une liste de ces fonctions: <http://msdn.microsoft.com/library/default.asp?url=/library/en-us/mslu/winprog/other_existing_unicode_support.asp> | |
| 361 | 363 | ||
| 362 | 364 | Exemple de conversion: | |
| 363 | 365 | ||
| 364 | 366 | ``` pascal | |
| 365 | 367 | GetTextExtentPoint32(hdcNewBitmap, LPSTR(ButtonCaption), | |
| 366 | 368 | Length(ButtonCaption), TextSize); | |
| 367 | 369 | ``` | |
| 368 | 370 | ||
| 369 | 371 | Devient: | |
| 370 | 372 | ||
| 371 | 373 | ``` pascal | |
| 372 | 374 | {$ifdef WindowsUnicodeSupport} | |
| 373 | 375 | GetTextExtentPoint32W(hdcNewBitmap, PWideChar(Utf8Decode(ButtonCaption)), Length(WideCaption), TextSize); | |
| 374 | 376 | {$else} | |
| 375 | 377 | GetTextExtentPoint32(hdcNewBitmap, LPSTR(ButtonCaption), Length(ButtonCaption), TextSize); | |
| 376 | 378 | {$endif} | |
| 377 | 379 | ``` | |
| 378 | 380 | ||
| 379 | 381 | #### Fonctions qui nécessitent des versions Ansi et Wide | |
| 380 | 382 | ||
| 381 | 383 | Premier exemple de Conversion: | |
| 382 | 384 | ||
| 383 | 385 | ``` pascal | |
| 384 | 386 | function TGDIWindow.GetTitle: String; | |
| 385 | 387 | var | |
| 386 | 388 | l: Integer; | |
| 387 | 389 | begin | |
| 388 | 390 | l := Windows.GetWindowTextLength(Handle); | |
| 389 | 391 | SetLength(Result, l); | |
| 390 | 392 | Windows.GetWindowText(Handle, @Result[1], l); | |
| 391 | 393 | end; | |
| 392 | 394 | ``` | |
| 393 | 395 | ||
| 394 | 396 | Devient: | |
| 395 | 397 | ||
| 396 | 398 | ``` pascal | |
| 397 | 399 | function TGDIWindow.GetTitle: String; | |
| 398 | 400 | var | |
| 399 | 401 | l: Integer; | |
| 400 | 402 | AnsiBuffer: string; | |
| 401 | 403 | WideBuffer: WideString; | |
| 402 | 404 | begin | |
| 403 | 405 | ||
| 404 | 406 | {$ifdef WindowsUnicodeSupport} | |
| 405 | 407 | ||
| 406 | 408 | if UnicodeEnabledOS then | |
| 407 | 409 | begin | |
| 408 | 410 | l := Windows.GetWindowTextLengthW(Handle); | |
| 409 | 411 | SetLength(WideBuffer, l); | |
| 410 | 412 | l := Windows.GetWindowTextW(Handle, @WideBuffer[1], l); | |
| 411 | 413 | SetLength(WideBuffer, l); | |
| 412 | 414 | Result := Utf8Encode(WideBuffer); | |
| 413 | 415 | end | |
| 414 | 416 | else | |
| 415 | 417 | begin | |
| 416 | 418 | l := Windows.GetWindowTextLength(Handle); | |
| 417 | 419 | SetLength(AnsiBuffer, l); | |
| 418 | 420 | l := Windows.GetWindowText(Handle, @AnsiBuffer[1], l); | |
| 419 | 421 | SetLength(AnsiBuffer, l); | |
| 420 | 422 | Result := AnsiToUtf8(AnsiBuffer); | |
| 421 | 423 | end; | |
| 422 | 424 | ||
| 423 | 425 | {$else} | |
| 424 | 426 | ||
| 425 | 427 | l := Windows.GetWindowTextLength(Handle); | |
| 426 | 428 | SetLength(Result, l); | |
| 427 | 429 | Windows.GetWindowText(Handle, @Result[1], l); | |
| 428 | 430 | ||
| 429 | 431 | {$endif} | |
| 430 | 432 | ||
| 431 | 433 | end; | |
| 432 | 434 | ``` | |
| 433 | 435 | ||
| 434 | 436 | ### Captures d'écran | |
| 435 | 437 | ||
| 436 | 438 | 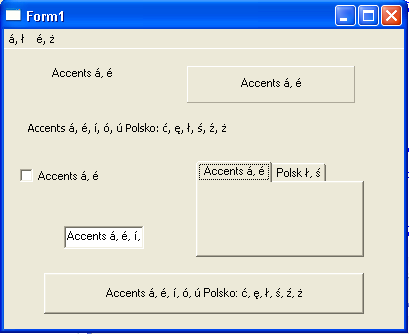 | |
| 437 | 439 | ||
| 438 | 440 | # Pages de code FPC | |
| 439 | 441 | ||
| 440 | 442 | Pourquoi la LCL n'utilise pas les pages de code (codepage) pour les sources ? | |
| 441 | 443 | ||
| 442 | 444 | Les -Fcutf8 et {\$codepage utf8} existent depuis longtemps. | |
| 443 | 445 | ||
| 444 | 446 | Le programme suivant nécessite FPC 2.7.1. Le problème suivant existe aussi sur les plus vieux compilateurs. | |
| 445 | 447 | ||
| 446 | 448 | Il y a quelques pièges avec -Fcutf8 et{\$codepage utf8}. Ca marche seulement si le DefaultSystemCodePage de la RTL est CP_UTF8. Sinon, vos chaines sont converties par le compilateur. | |
| 447 | 449 | ||
| 448 | 450 | Par exemple, sous Linux, le paramétrage par défaut est CP_ACP, qui devient ISO_8859-1. La RTL **ne** lit **pas** toute seule le langage de votre environnement. Donc l'encodage par défaut est ISO_8859-1. Cela signifie que vos constantes chaîne UTF-8 sont converties par le compilateur : | |
| 449 | 451 | ||
| 450 | 452 | Compilez ceci avec -Fcutf8 et lancez-le sur un linux avec LANG paramétré à utf-8: | |
| 451 | 453 | ||
| 452 | 454 | ``` pascal | |
| 453 | 455 | program project1; | |
| 454 | 456 | {$mode objfpc}{$H+} | |
| 455 | 457 | begin | |
| 456 | 458 | writeln(DefaultSystemCodePage,' ',CP_UTF8); | |
| 457 | 459 | writeln('ä'); | |
| 458 | 460 | end. | |
| 459 | 461 | ``` | |
| 460 | 462 | ||
| 461 | 463 | Résultat : | |
| 462 | 464 | ||
| 463 | 465 | 0 65001 | |
| 464 | 466 | ä | |
| 465 | 467 | ||
| 466 | 468 | La LCL utilise un gestionnaire de widestring (cwstring pour le moment), qui paramètre le DefaultSystemCodePage. Vous pouvez faire de même dans vos programmes non-LCL : | |
| 467 | 469 | ||
| 468 | 470 | ``` pascal | |
| 469 | 471 | program project1; | |
| 470 | 472 | {$mode objfpc}{$H+} | |
| 471 | 473 | uses cwstring; | |
| 472 | 474 | begin | |
| 473 | 475 | writeln(DefaultSystemCodePage,' ',CP_UTF8); | |
| 474 | 476 | writeln('ä'); | |
| 475 | 477 | end. | |
| 476 | 478 | ``` | |
| 477 | 479 | ||
| 478 | 480 | Résultat : | |
| 479 | 481 | ||
| 480 | 482 | 65001 65001 | |
| 481 | 483 | ä | |
| 482 | 484 | ||
| 483 | 485 | Ce qui précède est toutefois une simplification, un mensonge pour enfants. Prenons le programme suivant : | |
| 484 | 486 | ||
| 485 | 487 | ``` pascal | |
| 486 | 488 | program project1; | |
| 487 | 489 | {$mode objfpc}{$H+} | |
| 488 | 490 | uses cwstring; | |
| 489 | 491 | var | |
| 490 | 492 | a,b,c: string; | |
| 491 | 493 | begin | |
| 492 | 494 | writeln(DefaultSystemCodePage,' ',CP_UTF8); | |
| 493 | 495 | a:='ä'; b:='='#$C3#$A4; // #$C3#$A4 is UTF-8 for ä | |
| 494 | 496 | c:= 'ä='#$C3#$A4; | |
| 495 | 497 | writeln(a,b); // writes ä=ä | |
| 496 | 498 | writeln(c); // writes ä=ä | |
| 497 | 499 | end. | |
| 498 | 500 | ``` | |
| 499 | 501 | ||
| 500 | 502 | 65001 65001 | |
| 501 | 503 | ä=ä | |
| 502 | 504 | ä=ä | |
| 503 | 505 | ||
| 504 | 506 | Vous pouvez voir que les constantes chaîne en UTF-8 marchent, que les constantes chaînes avec des codes UTF-8 marchent aussi, mais que la combinaison ne marche pas. Ca a été compilé avec -Fcutf8 et utilise cwstring pour fixer le DefaultSystemCodePage à CP_UTF8. | |
| 505 | 507 | ||
| 506 | 508 | Alors qu'est-ce qui cloche ? | |
| 507 | 509 | ||
| 508 | 510 | Le compilateur traite toute constante chaine non ASCII (ici : le "ä") comme des widestring (UCS2, pas UTF-16). | |
| 509 | 511 | ||
| 510 | 512 | Vous ne pouvez pas tromper le compilateur avec 'ä='+#\$C3#\$A4. Vous devez définir deux constantes chaînes différentes. | |
| 511 | 513 | ||
| 512 | 514 | Utiliser n'importe quel caractère hors de la plage UCS-2 résulte en un | |
| 513 | 515 | ||
| 514 | 516 | Fatal: illegal character "'�'" ($F0) | |
| 515 | 517 | ||
| 516 | 518 | Vous pouvez les spécifier avec des codes UTF-16 : *\#\$D834#\$DD1E*. Oui, vous avez bien lu. Spécifier une page de code avec -Fcutf8 ou {\$codepage utf8} défini en fait un mélange d'UTF-8 et d'UTF-16. | |
| 517 | 519 | ||
| 518 | 520 | Maintenant, compilez le même programme sans -Fcutf8: | |
| 519 | 521 | ||
| 520 | 522 | 65001 65001 | |
| 521 | 523 | ä=ä | |
| 522 | 524 | ä=ä | |
| 523 | 525 | ||
| 524 | 526 | Ouah, tout marche comme prévu. Vous pouvez même mixer des constantes chaînes ASCII et non-ASCII. Sans page de code, le compilateur stocke les constantes chaine comme des séquences d'octets. C'est exactement ce qu'est UTF-8. | |
| 525 | 527 | ||
| 526 | 528 | C'est une des raisons pour lesquelles les applications LCL n'utilisent pas les drapeaux de page de code (codepage flags). | |
| 527 | 529 | ||
| 528 | 530 | msegui a implémenté un écosystème de widestrings, qui marche mieux avec un code de page. | |
| 529 | 531 | ||
| 530 | 532 | # Voir aussi | |
| 531 | 533 | ||
| 532 | 534 | - [[Character and string types/fr|Types caractère et chaîne]] | |
| 533 | 535 | - [[UTF-8/fr|UTF-8]] - Description des chaines UTF-8 | |
| 534 | 536 | - [[FPC Unicode support/fr|Support d'Unicode par FPC]] | |
| 535 | 537 | - [[for-in loop/fr|for-in_loop/fr#Traversée_de_chaînes_UTF-8]] - Fragment de code qui montre comment traverser les chaînes UTF8 | |
| 536 | 538 | - [[unicode use cases/fr|cas d'utilisation d'Unicode]] | |
| 537 | 539 | ||
| 538 | 540 | --- | |
| 539 | 541 | *From the Free Pascal wiki, page "LCL Unicode Support/fr", as it stood on 2020-02-19 after a change by Trev, out of the wiki's dump of 2024-05-26. Copyright stays with the author who wrote it, according to the old wiki's [[Licensing]] page. If you have concerns about this material, [message the admin](/wiki-contact).* |