

LCL Unicode Support/es: what changed
Revision 1 to 2. Removed lines have a minus sign; added lines have a plus sign.
| Old | New | Line | |
|---|---|---|---|
| 1 | 1 | ## Introducción | |
| 2 | 2 | ||
| 3 | 3 | En la versión 0.9.25, Lazarus tiene soporte completo para Unicode en todas las plataformas a excepción de Gtk 1. En esta página se pueden encontrar instrucciones para usuarios de Lazarus, roadmaps, descripción de conceptos básicos y detalles de implementación. | |
| 4 | 4 | ||
| 5 | 5 | ## Instrucciones para usuarios | |
| 6 | 6 | ||
| 7 | 7 | En los widgetsets unicode es importante hacer ver que no todo es Unicode. Las librerías Runtime Free Pascal y FCL son ANSI. Es responsabilidad del desarrollador conocer cual es la codificación de sus cadenas y realizar la conversión apropiada entre librerías que esperan diferentes codificaciones. | |
| 8 | 8 | ||
| 9 | 9 | Usualmente la codificación es por librería. Cada librería esperará uniformemente un tipo de codificación, que será habitualmente o bien UNICODE (UTF-8 para Lazarus) o ANSI (lo cual significa que es la codificación del sistema, que puede ser UTF-8 o no). Tanto RTL como FCL de Free Pascal Compiler (FPC) 2.2.2 esperan cadenas ANSI (también FPC 2.3.x). | |
| 10 | 10 | ||
| 11 | 11 | Se puede realizar la conversión entre UNICODE y ANSI utilizando las funciones UTF8ToAnsi y AnsiToUTF8 de la unit System o bien las funciones UTF8ToSys y SysToUTF8 de la unidad FileUtil. Las dos últimas son más elegantes pero insertan más código en el programa. | |
| 12 | 12 | ||
| 13 | 13 | Ejemplos: | |
| 14 | 14 | ||
| 15 | 15 | Digamos que tienes una cadena desde un TEdit y necesitas pasársela a alguna rutina de fichero rtl: | |
| 16 | 16 | ||
| 17 | 17 | ``` pascal | |
| 18 | 18 | var | |
| 19 | 19 | miCadena: string; // codificación utf-8 | |
| 20 | 20 | begin | |
| 21 | 21 | miCadena := miTEdit.Text; | |
| 22 | 22 | unaRutinaRTL(UTF8ToAnsi(miCadena)); | |
| 23 | 23 | end; | |
| 24 | 24 | ``` | |
| 25 | 25 | ||
| 26 | 26 | Y en el modo inverso: | |
| 27 | 27 | ||
| 28 | 28 | ``` pascal | |
| 29 | 29 | var | |
| 30 | 30 | miCadena: string; // codificada ansi | |
| 31 | 31 | begin | |
| 32 | 32 | miCadena := unaRutinaRTL; | |
| 33 | 33 | miTEdit.Text := AnsiToUTF8(miCadena); | |
| 34 | 34 | end; | |
| 35 | 35 | ``` | |
| 36 | 36 | ||
| 37 | 37 | **Importante**: UTF8ToAnsi retornará una cadena vacía si la cadena UTF8 contiene caracteres no válidos. | |
| 38 | 38 | ||
| 39 | 39 | **Importante**: AnsiToUTF8 y UTF8ToAnsi requiere un gestor de cadenas largas bajo Linux, BSD y Mac OS X. Puedes utilizar las funciones SysToUTF8 y UTF8ToSys (unidad FileUtil) o añadir un gestor de cadenas largas mediante cwstring como unidad en la sección *uses*. | |
| 40 | 40 | ||
| 41 | 41 | ### Tratamiento de cadenas UTF-8 y de caracteres | |
| 42 | 42 | ||
| 43 | 43 | Si deseamos actuar sobre los caracteres de una cadena UTF8, básicamente hay dos maneras. | |
| 44 | 44 | ||
| 45 | 45 | - actuar sobre los bytes - útil para buscar una subcadena o cuando se busca sólo en los caracteres ASCII de la cadena UTF8. Por ejemplo, al analizar archivos xml. | |
| 46 | 46 | - actuar a través de los caracteres - útil para componentes gráficos como SynEdit. Por ejemplo cuando se desea conocer el tercer carácter que aparece en la pantalla. | |
| 47 | 47 | ||
| 48 | 48 | #### Buscando una subcadena | |
| 49 | 49 | ||
| 50 | 50 | Debido a la naturaleza especial de UTF8 podemos simplemente usar las funciones normales de cadena: | |
| 51 | 51 | ||
| 52 | 52 | ``` pascal | |
| 53 | 53 | procedure Where(SearchFor, aText: string); | |
| 54 | 54 | var | |
| 55 | 55 | BytePos: LongInt; | |
| 56 | 56 | CharacterPos: LongInt; | |
| 57 | 57 | begin | |
| 58 | 58 | BytePos:=Pos(SearchFor,aText); | |
| 59 | 59 | CharacterPos:=UTF8Length(PChar(aText),BytePos-1); | |
| 60 | 60 | writeln('La subcadena "',SearchFor,'" está en el texto "',aText,'"', | |
| 61 | 61 | ' en la posición de byte ',BytePos,' y en la posición de caracter ',CharacterPos); | |
| 62 | 62 | end; | |
| 63 | 63 | ``` | |
| 64 | 64 | ||
| 65 | 65 | #### Accediendo a los caracteres UTF8 | |
| 66 | 66 | ||
| 67 | 67 | Los caracteres Unicode pueden variar en longitud, por lo que la mejor solución para acceder a ellos es usar una iteración cuando queremos acceder a los caracteres en la secuencia en la que se encuentran. Para ello podemos utilizar este código: | |
| 68 | 68 | ||
| 69 | 69 | ``` pascal | |
| 70 | 70 | uses lazutf8; // LCLProc para Lazarus 0.9.30 o inferior | |
| 71 | 71 | ... | |
| 72 | 72 | procedure DoSomethingWithString(AnUTF8String: string); | |
| 73 | 73 | var | |
| 74 | 74 | p: PChar; | |
| 75 | 75 | CharLen: integer; | |
| 76 | 76 | FirstByte, SecondByte, ThirdByte: Char; | |
| 77 | 77 | begin | |
| 78 | 78 | p:=PChar(AnUTF8String); | |
| 79 | 79 | repeat | |
| 80 | 80 | CharLen := UTF8CharacterLength(p); | |
| 81 | 81 | ||
| 82 | 82 | // Ahora tenemos un puntero al caracter y su longitud | |
| 83 | 83 | // Podemos acceder a los bytes del caracter UTF-8 así: | |
| 84 | 84 | if CharLen >= 1 then FirstByte := P[0]; | |
| 85 | 85 | if CharLen >= 2 then SecondByte := P[1]; | |
| 86 | 86 | if CharLen >= 3 then ThirdByte := P[2]; | |
| 87 | 87 | ||
| 88 | 88 | inc(p,CharLen); | |
| 89 | 89 | until (CharLen=0) or (p^ = #0); | |
| 90 | 90 | end; | |
| 91 | 91 | ``` | |
| 92 | 92 | ||
| 93 | 93 | #### Acceder al enésimo caracter UTF8 | |
| 94 | 94 | ||
| 95 | 95 | Además de la iteración, podemos querer tambien realizar un acceso aleatorio a los caracteres UTF-8. | |
| 96 | 96 | ||
| 97 | 97 | ``` pascal | |
| 98 | 98 | uses lazutf8; // LCLProc para Lazarus 0.9.30 o inferior | |
| 99 | 99 | ... | |
| 100 | 100 | var | |
| 101 | 101 | AnUTF8String, NthChar: string; | |
| 102 | 102 | begin | |
| 103 | 103 | NthChar := UTF8Copy(AnUTF8String, N, 1); | |
| 104 | 104 | ``` | |
| 105 | 105 | ||
| 106 | 106 | #### Iterar sobre los puntos de código usando UTF8CharacterToUnicode | |
| 107 | 107 | ||
| 108 | 108 | A continuación se muestra cómo recorrer en iteración el valor del código de 32 bits de punto para cada carácter de una cadena UTF8: | |
| 109 | 109 | ||
| 110 | 110 | ``` pascal | |
| 111 | 111 | uses lazutf8; // LCLProc para Lazarus 0.9.30 o inferior | |
| 112 | 112 | ... | |
| 113 | 113 | procedure IterateUTF8Characters(const AnUTF8String: string); | |
| 114 | 114 | var | |
| 115 | 115 | p: PChar; | |
| 116 | 116 | unicode: Cardinal; | |
| 117 | 117 | CharLen: integer; | |
| 118 | 118 | begin | |
| 119 | 119 | p:=PChar(AnUTF8String); | |
| 120 | 120 | repeat | |
| 121 | 121 | unicode:=UTF8CharacterToUnicode(p,CharLen); | |
| 122 | 122 | writeln('Unicode=',unicode); | |
| 123 | 123 | inc(p,CharLen); | |
| 124 | 124 | until (CharLen=0) or (unicode=0); | |
| 125 | 125 | end; | |
| 126 | 126 | ``` | |
| 127 | 127 | ||
| 128 | 128 | #### UTF-8: Copiar cadena, Longitud, Minúsculas, etc | |
| 129 | 129 | ||
| 130 | 130 | Casi todas las operaciones que podríamos querer ejecutar con cadenas UTF-8 están cubiertas por las rutinas en la unidad de lazutf8 (unidad LCLProc en Lazarus 0.9.30 o inferior). Consulte la siguiente lista de las rutinas de tomada de lazutf8.pas: | |
| 131 | 131 | ||
| 132 | 132 | ``` pascal | |
| 133 | 133 | function UTF8CharacterLength(p: PChar): integer; | |
| 134 | 134 | function UTF8Length(const s: string): PtrInt; | |
| 135 | 135 | function UTF8Length(p: PChar; ByteCount: PtrInt): PtrInt; | |
| 136 | 136 | function UTF8CharacterToUnicode(p: PChar; out CharLen: integer): Cardinal; | |
| 137 | 137 | function UnicodeToUTF8(u: cardinal; Buf: PChar): integer; inline; | |
| 138 | 138 | function UnicodeToUTF8SkipErrors(u: cardinal; Buf: PChar): integer; | |
| 139 | 139 | function UnicodeToUTF8(u: cardinal): shortstring; inline; | |
| 140 | 140 | function UTF8ToDoubleByteString(const s: string): string; | |
| 141 | 141 | function UTF8ToDoubleByte(UTF8Str: PChar; Len: PtrInt; DBStr: PByte): PtrInt; | |
| 142 | 142 | function UTF8FindNearestCharStart(UTF8Str: PChar; Len: integer; | |
| 143 | 143 | BytePos: integer): integer; | |
| 144 | 144 | // encontrar el caracter enésimo UTF8, ignorando BIDI | |
| 145 | 145 | function UTF8CharStart(UTF8Str: PChar; Len, CharIndex: PtrInt): PChar; | |
| 146 | 146 | // encontrar el ínidice de bytedel enésimo caracter UTF8, ignorando BIDI (longitud en bytes de la subcadena) | |
| 147 | 147 | function UTF8CharToByteIndex(UTF8Str: PChar; Len, CharIndex: PtrInt): PtrInt; | |
| 148 | 148 | procedure UTF8FixBroken(P: PChar); | |
| 149 | 149 | function UTF8CharacterStrictLength(P: PChar): integer; | |
| 150 | 150 | function UTF8CStringToUTF8String(SourceStart: PChar; SourceLen: PtrInt) : string; | |
| 151 | 151 | function UTF8Pos(const SearchForText, SearchInText: string): PtrInt; | |
| 152 | 152 | function UTF8Copy(const s: string; StartCharIndex, CharCount: PtrInt): string; | |
| 153 | 153 | procedure UTF8Delete(var s: String; StartCharIndex, CharCount: PtrInt); | |
| 154 | 154 | procedure UTF8Insert(const source: String; var s: string; StartCharIndex: PtrInt); | |
| 155 | 155 | ||
| 156 | 156 | function UTF8LowerCase(const AInStr: string; ALanguage: string=''): string; | |
| 157 | 157 | function UTF8UpperCase(const AInStr: string; ALanguage: string=''): string; | |
| 158 | 158 | function FindInvalidUTF8Character(p: PChar; Count: PtrInt; | |
| 159 | 159 | StopOnNonASCII: Boolean = false): PtrInt; | |
| 160 | 160 | function ValidUTF8String(const s: String): String; | |
| 161 | 161 | ||
| 162 | 162 | procedure AssignUTF8ListToAnsi(UTF8List, AnsiList: TStrings); | |
| 163 | 163 | ||
| 164 | 164 | //funciones de comparación | |
| 165 | 165 | ||
| 166 | 166 | function UTF8CompareStr(const S1, S2: string): Integer; | |
| 167 | 167 | function UTF8CompareText(const S1, S2: string): Integer; | |
| 168 | 168 | ``` | |
| 169 | 169 | ||
| 170 | 170 | ### Tratando con directorios y nombres de fichero | |
| 171 | 171 | ||
| 172 | 172 | Las funciones y controles de Lazarus esperan nombres de directorios y ficheros con la codificación UTF-8, pero RTL utiliza cadenas ANSI para los mismos. | |
| 173 | 173 | ||
| 174 | 174 | Por ejemplo, consideremos un botón, que establece la propiedad directorio de TFileListBox al valor del directorio actual. La función RTL [[doc:rtl/sysutils/getcurrentdir.html|GetCurrentDir]] es ANSI, y no UNICODE, lo cual precisa de una conversión: | |
| 175 | 175 | ||
| 176 | 176 | ``` pascal | |
| 177 | 177 | procedure TForm1.Boton1Click(Sender: TObject); | |
| 178 | 178 | begin | |
| 179 | 179 | FileListBox1.Directory:=SysToUTF8(GetCurrentDir); | |
| 180 | 180 | // o usar las funciones de la unidad FileUtil | |
| 181 | 181 | FileListBox1.Directory:=GetCurrentDirUTF8; | |
| 182 | 182 | end; | |
| 183 | 183 | ``` | |
| 184 | 184 | ||
| 185 | 185 | La unidad FileUtil define funciones comunes de fichero con cadenas UTF-8: | |
| 186 | 186 | ||
| 187 | 187 | ``` pascal | |
| 188 | 188 | // funciones básicas similares a la RTL pero trabajando con UTF-8 en lugar de | |
| 189 | 189 | // codif cación de sistema | |
| 190 | 190 | // AnsiToUTF8 y UTF8ToAnsi necesitan un gestor de cadenas largas (widestring) bajo Linux, BSD, MacOSX | |
| 191 | 191 | // pero normalmente estos sistemas operativos utilizan UTF-8 como sistema de codificación | |
| 192 | 192 | // por lo que el gestor de cadenas largas no es necesario. | |
| 193 | 193 | ||
| 194 | 194 | function NeedRTLAnsi: boolean;// true si la codificación no es UTF-8 | |
| 195 | 195 | procedure SetNeedRTLAnsi(NewValue: boolean); | |
| 196 | 196 | function UTF8ToSys(const s: string): string;// como UTF8ToAnsi pero más independiente de widestringmanager | |
| 197 | 197 | function SysToUTF8(const s: string): string;// como AnsiToUTF8 pero mas independiente de widestringmanager | |
| 198 | 198 | ||
| 199 | 199 | // operaciones de fichero | |
| 200 | 200 | function FileExistsUTF8(const Filename: string): boolean; | |
| 201 | 201 | function FileAgeUTF8(const FileName: string): Longint; | |
| 202 | 202 | function DirectoryExistsUTF8(const Directory: string): Boolean; | |
| 203 | 203 | function ExpandFileNameUTF8(const FileName: string): string; | |
| 204 | 204 | function ExpandUNCFileNameUTF8(const FileName: string): string; | |
| 205 | 205 | {$IFNDEF VER2_2_0} | |
| 206 | 206 | function ExtractShortPathNameUTF8(Const FileName : String) : String; | |
| 207 | 207 | {$ENDIF} | |
| 208 | 208 | function FindFirstUTF8(const Path: string; Attr: Longint; out Rslt: TSearchRec): Longint; | |
| 209 | 209 | function FindNextUTF8(var Rslt: TSearchRec): Longint; | |
| 210 | 210 | procedure FindCloseUTF8(var F: TSearchrec); | |
| 211 | 211 | function FileSetDateUTF8(const FileName: String; Age: Longint): Longint; | |
| 212 | 212 | function FileGetAttrUTF8(const FileName: String): Longint; | |
| 213 | 213 | function FileSetAttrUTF8(const Filename: String; Attr: longint): Longint; | |
| 214 | 214 | function DeleteFileUTF8(const FileName: String): Boolean; | |
| 215 | 215 | function RenameFileUTF8(const OldName, NewName: String): Boolean; | |
| 216 | 216 | function FileSearchUTF8(const Name, DirList : String): String; | |
| 217 | 217 | function FileIsReadOnlyUTF8(const FileName: String): Boolean; | |
| 218 | 218 | function GetCurrentDirUTF8: String; | |
| 219 | 219 | function SetCurrentDirUTF8(const NewDir: String): Boolean; | |
| 220 | 220 | function CreateDirUTF8(const NewDir: String): Boolean; | |
| 221 | 221 | function RemoveDirUTF8(const Dir: String): Boolean; | |
| 222 | 222 | function ForceDirectoriesUTF8(const Dir: string): Boolean; | |
| 223 | 223 | ||
| 224 | 224 | // entorno | |
| 225 | 225 | function ParamStrUTF8(Param: Integer): string; | |
| 226 | 226 | function GetEnvironmentStringUTF8(Index : Integer): String; | |
| 227 | 227 | function GetEnvironmentVariableUTF8(const EnvVar: String): String; | |
| 228 | 228 | function GetAppConfigDirUTF8(Global: Boolean): string; | |
| 229 | 229 | ``` | |
| 230 | 230 | ||
| 231 | 231 | Aunque la mayor parte de los parámetros pasados a estas funciones tienen unos tipos más simples otros tienen más complejidad, por eso añado aquí contenido para no tener que ir a buscar a otro sitio: Descripción de recursos utilizados: | |
| 232 | 232 | ||
| 233 | 233 | ``` pascal | |
| 234 | 234 | function FindFirstUTF8( | |
| 235 | 235 | filtro:string; // le indicamos el filtro a utilizar por ejemplo *.*, *.txt, *.exe.... | |
| 236 | 236 | Attr: LongInt; // atributos de búsqueda | |
| 237 | 237 | out Rslt: TSearchRec // devuelve el resultado buscado con respecto a path y Attr | |
| 238 | 238 | ):LongInt; | |
| 239 | 239 | ||
| 240 | 240 | // Para establecer la trayectoria donde empezar a buscar se lo indicamos con SetCurrentDir() | |
| 241 | 241 | // por ejemplo SetCurrentDir ('c:\'). | |
| 242 | 242 | // Para saber que trayectoria ha establecido realmente se lo podemos preguntar con GetCurrentDir | |
| 243 | 243 | // claro que podemos recurrir al resultado de la llamada para saber si tuvo exito pero de todos | |
| 244 | 244 | // modos definimos una variable string directorio_actual:string y luego directorio_actual:=GetCurrentDir(); | |
| 245 | 245 | // | |
| 246 | 246 | // Para encontrar sucesivas entradas se necesitaría utilizar FindNextUTF8. | |
| 247 | 247 | // Para liberar los recursos utilizados podemos emplear FindCloseUTF8. | |
| 248 | 248 | ||
| 249 | 249 | // Attr: LongInt donde los atributos pueden ser los siguientes: | |
| 250 | 250 | // | |
| 251 | 251 | // faReadOnly = $00000001; | |
| 252 | 252 | // http://community.freepascal.org:10000/docs-html/rtl/sysutils/fareadonly.html | |
| 253 | 253 | // const faHidden = $00000002; | |
| 254 | 254 | // http://community.freepascal.org:10000/docs-html/rtl/sysutils/fahidden.html | |
| 255 | 255 | // | |
| 256 | 256 | // const faSysFile = $00000004; | |
| 257 | 257 | // http://community.freepascal.org:10000/docs-html/rtl/sysutils/fasysfile.html | |
| 258 | 258 | // const faVolumeId = $00000008; | |
| 259 | 259 | // http://community.freepascal.org:10000/docs-html/rtl/sysutils/favolumeid.html | |
| 260 | 260 | // const faDirectory = $00000010; | |
| 261 | 261 | // http://community.freepascal.org:10000/docs-html/rtl/sysutils/fadirectory.html | |
| 262 | 262 | // const faArchive = $00000020; | |
| 263 | 263 | // http://community.freepascal.org:10000/docs-html/rtl/sysutils/faarchive.html | |
| 264 | 264 | // const faAnyFile = $0000003f; | |
| 265 | 265 | // http://community.freepascal.org:10000/docs-html/rtl/sysutils/faanyfile.html | |
| 266 | 266 | // const faSymLink = $00000040; | |
| 267 | 267 | // http://community.freepascal.org:10000/docs-html/rtl/sysutils/fasymlink.html | |
| 268 | 268 | // Son constantes que se pueden usar tal cual o por su valor numérico (longint) | |
| 269 | 269 | // como puede ser $00000008 para obtener el volumen de la unidad de disco. | |
| 270 | 270 | // He recogido la información basándome en FindFirst no FindFirstUTF si me equivoco | |
| 271 | 271 | // que me corrijan, además para sistemas Linux he encontrado esto: | |
| 272 | 272 | // It is not recommended to use findfirst/findnext on Linux. | |
| 273 | 273 | // It is an (ineffective) emulation. Instead try using the linux unit | |
| 274 | 274 | // and using 'Glob' instead. | |
| 275 | 275 | // | |
| 276 | 276 | // I have plans for a better findfirst/findnext algorithm on Linux, | |
| 277 | 277 | // but I need some time to implement it. | |
| 278 | 278 | // | |
| 279 | 279 | //-- Michael Van Canneyt, 18 octubre 2000 15:10 | |
| 280 | 280 | // De eso ya hace tiempo, yo aún no he podido practicar el equivalente en Linux | |
| 281 | 281 | // pero lo dejo de referencia. | |
| 282 | 282 | ``` | |
| 283 | 283 | ||
| 284 | 284 | ``` pascal | |
| 285 | 285 | type TSearchRec = record | |
| 286 | 286 | Time: LongInt; // Timestamp del fichero. | |
| 287 | 287 | Size: Int64; // Tamaño del fichero. | |
| 288 | 288 | Attr: LongInt; // Atributos del fichero. | |
| 289 | 289 | Name: TFilename; // Nombre del fichero (no parte de directorio). | |
| 290 | 290 | ExcludeAttr: LongInt; // Atributos a excluir de la búsqueda (no usar). | |
| 291 | 291 | FindHandle: Pointer; // Manejador (handle) interno del sistema operativo(no usar). | |
| 292 | 292 | Mode: TMode; //Modo de fichero UNIX. Solo usado en sistemas UNIX. | |
| 293 | 293 | PathOnly: AnsiString; // trayecto de un fichero. | |
| 294 | 294 | end; | |
| 295 | 295 | // donde type TFilename = String; | |
| 296 | 296 | // | |
| 297 | 297 | ``` | |
| 298 | 298 | ||
| 299 | 299 | El siguiente es un pequeño ejemplo aplicado a un botón: Creamos varias etiquetas (TLabel) en las que por medio de su propiedad caption visualizaremos los resultados | |
| 300 | 300 | ||
| 301 | 301 | ``` pascal | |
| 302 | 302 | procedure TForm1.Button1Click(Sender: TObject); | |
| 303 | 303 | var | |
| 304 | 304 | lista_ficheros:TSearchRec; | |
| 305 | 305 | directorio_actual:string; | |
| 306 | 306 | trayecto: string; | |
| 307 | 307 | begin | |
| 308 | 308 | lista_ficheros.name:=' '; | |
| 309 | 309 | SetCurrentDir('c:\'); | |
| 310 | 310 | label1.caption:='El directorio actual es: '+GetCurrentDir(); | |
| 311 | 311 | if findfirstutf8 ('*.*',faAnyFile,lista_ficheros) = 0 then | |
| 312 | 312 | begin | |
| 313 | 313 | if findnextutf8 (lista_ficheros) = 0 then | |
| 314 | 314 | label2.caption:=lista_ficheros.name; | |
| 315 | 315 | if findnextutf8 (lista_ficheros) = 0 then; | |
| 316 | 316 | label3.caption:=lista_ficheros.name; | |
| 317 | 317 | if findnextutf8 (lista_ficheros) = 0 then; | |
| 318 | 318 | label4.caption:=lista_ficheros.name; | |
| 319 | 319 | if findnextutf8 (lista_ficheros) = 0 then; | |
| 320 | 320 | label5.caption:=lista_ficheros.name; | |
| 321 | 321 | findcloseutf8 (lista_ficheros); | |
| 322 | 322 | end | |
| 323 | 323 | else | |
| 324 | 324 | label1.caption:='Hay un error en alguna parte'; | |
| 325 | 325 | end; | |
| 326 | 326 | ``` | |
| 327 | 327 | ||
| 328 | 328 | #### Mac OS X | |
| 329 | 329 | ||
| 330 | 330 | Las funciones de fichero de la unidad FileUtil tienen especial cuidado en Mac OS X: OS X normaliza los nombres de fichero. Por ejemplo el nombre de fichero 'ä.txt' puede ser codificado en unicode con dos secuencias diferentes (#\$C3#\$A4 y 'a'#\$CC#\$88). Bajo Linux y BSD se puede crear un nombre de fichero con ambas codificaciones. OS X convierte automáticamente la diéresis a una secuencia de tres bytes. Esto significa: | |
| 331 | 331 | ||
| 332 | 332 | ``` pascal | |
| 333 | 333 | if Filename1=Filename2 then ... // no es suficiente bajo OS X | |
| 334 | 334 | if AnsiCompareFileName(Filename1,Filename2)=0 then ... // no suficiente bajo fpc 2.2.2, incluso no con cwstring | |
| 335 | 335 | if CompareFilenames(Filename1,Filename2)=0 then ... // esto siempre funciona (unit FileUtil o FileProcs) | |
| 336 | 336 | ``` | |
| 337 | 337 | ||
| 338 | 338 | ## UTF8 y archivos fuente - el BOM desaparecido | |
| 339 | 339 | ||
| 340 | 340 | Al crear archivos de código fuente con Lazarus y escribir algunos caracteres no ASCII el archivo se guarda en UTF8. **No utiliza BOM** (marca de orden de byte). Puedes cambiar la codificación en el menú contextual sobre el editor con la opción *Ajustes de archivo... / Codificación*. La razón de la omisión de BOM es cómo trata Ansistrings FPC. Por compatibilidad la LCL usa Ansistrings y para la portabilidad del LCL utiliza UTF8. | |
| 341 | 341 | ||
| 342 | 342 | Nota:Algunos editores de texto de MS Windows podrían tratar los archivos como con codificación del sistema y mostrar caracteres no válidos. No agregue BOM. Si se agrega BOM tenemos que cambiar todas las asignaciones de cadena. | |
| 343 | 343 | ||
| 344 | 344 | Por ejemplo: | |
| 345 | 345 | ||
| 346 | 346 | ``` pascal | |
| 347 | 347 | Button1.Caption:='Über'; | |
| 348 | 348 | ``` | |
| 349 | 349 | ||
| 350 | 350 | Cuando no hay BOM (marca de orden de byte) y no nos pasan un parámetro de página de códigos el compilador trata la cadena como sistema de codificación y copia cada byte no convertido a la cadena. Así es como el LCL espera cadenas de texto. | |
| 351 | 351 | ||
| 352 | 352 | ``` pascal | |
| 353 | 353 | // el archivo fuente está guardado como UTF sin BOM | |
| 354 | 354 | if FileExists('Über.txt') then ; // erróneo, porque FileExists espera codificación del sistema | |
| 355 | 355 | if FileExistsUTF8('Über.txt') then ; // correcto | |
| 356 | 356 | ``` | |
| 357 | 357 | ||
| 358 | 358 | ## Widestrings y Ansistrings | |
| 359 | 359 | ||
| 360 | 360 | al pasar de Ansistrings a Widestrings hay que convertir la codificación. | |
| 361 | 361 | ||
| 362 | 362 | ``` pascal | |
| 363 | 363 | var | |
| 364 | 364 | w: widestring; | |
| 365 | 365 | begin | |
| 366 | 366 | w:='Über'; // erróneo, porque FPC convertirá la codificación del sistema a UTF16 | |
| 367 | 367 | w:=UTF8ToUTF16('Über'); // correcto | |
| 368 | 368 | Button1.Caption:=UTF16ToUTF8(w); | |
| 369 | 369 | end; | |
| 370 | 370 | ``` | |
| 371 | 371 | ||
| 372 | 372 | ## Archivos fuente con UTF8 BOM | |
| 373 | 373 | ||
| 374 | 374 | Si haces una gran cantidad de conversiones widestring en una unidad, el código podría ser más legible guardando el fuente como UTF8 con BOM. El compilador permite una codificación por unidad. | |
| 375 | 375 | ||
| 376 | 376 | ### Lenguajes del este asiático en Windows | |
| 377 | 377 | ||
| 378 | 378 | La fuente por defecto (Tahoma) para los controles de interface de usuario bajo Windows XP son capaces de mostrar correctamente varios lenguajes, incluyendo árabe, ruso y lenguajes del oeste, pero no lenguajes del este tales como chino, japones y coreano. Se puede escoger la fuente para la interfaz estándar de usuario modificando la configuración regional del sistema operativo en el panel de control, seleccionando en la solapa de lenguaje el que se necesite. De esta forma ya se podría visualizar correctamente en pantalla el lenguaje deseado. Obviamente las versiones de XP para estos idiomas deben contener dicho paquete de lenguaje instalado. Ver instrucciones en: [1](http://newton.uor.edu/Departments&Programs/AsianStudiesDept/Language/asianlanguageinstallation_XP.html) | |
| 379 | 379 | ||
| 380 | 380 | ## Guias de implementación | |
| 381 | 381 | ||
| 382 | 382 | ### Requerimientos | |
| 383 | 383 | ||
| 384 | 384 | El espíritu de Lazarus es: "Escribe el código una vez, compila donde quieras." Esto significa, idealmente, que una aplicación con soporte UNICODE habilitado debería tener una sola versión de código fuente soportada, sin defines condicionales en las diferentes plataformas destino. | |
| 385 | 385 | ||
| 386 | 386 | La parte "interface" de LCL debería soportar Unicode para las plataformas destino que las soportan ya por si mismas ocultando todas las peculiaridades para el programador de aplicaciones. | |
| 387 | 387 | ||
| 388 | 388 | En lo que concierne a Lazarus, la comunicación interna de cadenas en los límites "Código de aplicacion \<--\> LCL", así como "LCL \<--\> Widgetsets" está basada en las cadenas clásicas (orientadas al byte). Lógicamente, sus contenidos deberían codificarse de acuerdo a [[UTF-8]]. | |
| 389 | 389 | ||
| 390 | 390 | ### Migración a UNICODE | |
| 391 | 391 | ||
| 392 | 392 | Las versiones anteriores de Lazarus utilizan codificación ANSI, porque era la opción por defecto para Gtk1 y win32, hasta la versión 0.9.24. Ya con la versión 0.9.25 todos los widgetsets utilizarán UTF-8 por defecto (a excepción de gtk1, que solamente soporta UTF-8 cuando el sistema lo soporta, con sus correspondientes limitaciones). Por ello todas las aplicaciones que pasen cadenas directamente al interface (tanto las escritas en código o directamente mediante el inspector de objetos) necesitarán ser convertidas a UTF-8. | |
| 393 | 393 | ||
| 394 | 394 | Actualmente tenemos varios grupos de widgetsets, acordes a la codificación: | |
| 395 | 395 | ||
| 396 | 396 | - Interfaces que utilizan codificación ANSI: gtk (1) en sistemas ANSI. | |
| 397 | 397 | ||
| 398 | 398 | - Interfaces que utilizan codificación UTF-8: gtk (1) en sistemas UTF-8: gtk2, qt, fpGUI, carbon, win32, wince, all others. | |
| 399 | 399 | ||
| 400 | 400 | Ten en cuenta que gtk 1 se encuentra en ambos grupos ANSI y UTF-8. Esto se debe a que la codificación se controla mediante una variable de entorno en Gtk 1. | |
| 401 | 401 | ||
| 402 | 402 | Tal como es Lazarus a fecha de hoy, el software existente funcionará si se recompila para los interfaces de win32, winCE o gtk, pero presentará complicaciones de compilación para otros widgetset. Y el nuevo software utilizando UTF-8 funcionará cuando se recompile para cualquiera de los widgesets del grupo UNICODE. | |
| 403 | 403 | ||
| 404 | 404 | El IDE se ha extendido para cargar(load)/salvar(save)/editar(edit) ficheros con las diferentes codificaciones (una codificación por fichero). Tiene una construcción heurística para determinar la codificación y de esta forma se puede cambiar la codificación del fichero en cualquier momento (Source Editor / Popup Menu / File Settings/ Encoding) por lo que el IDE puede abrir ficheros y proyectos antiguos y de esta forma utilizarse para convertir a la codificación deseada. | |
| 405 | 405 | ||
| 406 | 406 | ## Recorrido | |
| 407 | 407 | ||
| 408 | 408 | Ahora que tenemos establecida la guia, es hora de crear un recorrido y ponerlo en práctica. Por ello se ha creado el siguiente plan. Dicho plan divide las tareas en dos grupos. Uno para las tareas primarias y otro para las secundarias. | |
| 409 | 409 | ||
| 410 | 410 | Todas las tareas primarias deben implementarse completamente antes de que se pueda decir que Lazarus tiene funcionalidad Unicode, y como tal debe prestarse especial atención a tal finalidad dedicándole el esfuerzo oportuno. | |
| 411 | 411 | ||
| 412 | 412 | Las tareas secundarias son deseables, pero no se implementarán a menos que algunos voluntarios se dediquen a ello o se presenten muchas peticiones. | |
| 413 | 413 | ||
| 414 | 414 | ### Tareas primarias | |
| 415 | 415 | ||
| 416 | 416 | **Hacer que Win32 Widgetset soporte UTF-8** | |
| 417 | 417 | ||
| 418 | 418 | Notas: en este paso nos centraremos en todas las versiones de 32 bits de Windows al mismo tiemo. Todo el código generado en este esfuerzo será aislado del actual interface win32 mediante IFDEFs, para evitar introducir errores en este interface primario. Después del tiempo de transición, los IFDEFs serán removidos y únicamente se mantendrá el código UNICODE. | |
| 419 | 419 | ||
| 420 | 420 | Estado: totalmente implementado. | |
| 421 | 421 | ||
| 422 | 422 | **Actualiza las funciones de teclado Gtk 2 para que trabajen con UTF-8** | |
| 423 | 423 | ||
| 424 | 424 | Notas: | |
| 425 | 425 | ||
| 426 | 426 | Estado: casi completo. Algunas características pre-editadas de gtk2 no están todavía soportadas en los controles customizados. Desconozco que lenguaje necesitan. | |
| 427 | 427 | ||
| 428 | 428 | **Hay que asegurarse de que el IDE de Lazarus funciona correctamente con el widgetset UNICODE de Win32 y que soporte UTF-8** | |
| 429 | 429 | ||
| 430 | 430 | Notas: | |
| 431 | 431 | ||
| 432 | 432 | Estado: completo. Excepto por el mapa de caracteres, el cual muestra solamente 255 caracteres. De todas formas todos los sistemas operativos modernos proveen mapas de caracteres manejables. | |
| 433 | 433 | ||
| 434 | 434 | **Hay que asegurarse de que el IDE de Lazarus funciona correctamente con el widgetset de Gtk2 y de si soporta UTF-8** | |
| 435 | 435 | ||
| 436 | 436 | Notas: | |
| 437 | 437 | ||
| 438 | 438 | Estado: completo. Hay errores gtk2 intf, pero no tienen nada que ver con UTF-8. | |
| 439 | 439 | ||
| 440 | 440 | ### Tareas secundarias | |
| 441 | 441 | ||
| 442 | 442 | **Actualizar el widgetset Windows CE para que utilice UTF-8** | |
| 443 | 443 | ||
| 444 | 444 | Notas: las rutinas de conversión de rutinas están concentrados en el fichero winceproc.pp. Se necesitan algunos tests. | |
| 445 | 445 | ||
| 446 | 446 | Estado: completado. | |
| 447 | 447 | ||
| 448 | 448 | **Actualiza las funciones de teclado de Gtk 1 para que trabajen con UTF-8** | |
| 449 | 449 | ||
| 450 | 450 | Notas: | |
| 451 | 451 | ||
| 452 | 452 | Estado: no implementado. | |
| 453 | 453 | ||
| 454 | 454 | **RTL completa en synedit** | |
| 455 | 455 | ||
| 456 | 456 | Notas: RTL significa de derecha a izquierda como por ejemplo el utilizado en árabe. | |
| 457 | 457 | ||
| 458 | 458 | Estado: no implementado. | |
| 459 | 459 | ||
| 460 | 460 | ## Esenciales de UNICODE | |
| 461 | 461 | ||
| 462 | 462 | UNICODE estándar mapea enteros (integers) de 0 a 10FFFF (h) a caracteres. Cada mapeo es llamado un punto de codigo. En otras palabras, los caracteres UNICODE están en principio definidos por puntos de código desde U+000000 a U+10FFFF (0 a 1 114 111). Unicode standard maps integers from 0 to 10FFFF(h) to characters. Each such mapping is called a code point. In other words, Unicode characters are in principle defined for code points from U+000000 to U+10FFFF en hexadecimal (0 to 1.114.111 en decimal). | |
| 463 | 463 | ||
| 464 | 464 | Existen tres esquemas para representar punto de código UNICODE como una única secuencia de bytes. Estos esquemas se llaman formatos de transformación UNICODE: UTF-8, UTF-16 y UTF-32. La conversión entre todos ellos es posible. Aquí están sus propiedades básicas: | |
| 465 | 465 | ||
| 466 | 466 | ` UTF-8 UTF-16 UTF-32`\ | |
| 467 | 467 | ` Smallest code point [hex] 000000 000000 000000`\ | |
| 468 | 468 | ` Largest code point [hex] 10FFFF 10FFFF 10FFFF`\ | |
| 469 | 469 | ` Code unit size [bits] 8 16 32`\ | |
| 470 | 470 | ` Minimal bytes/character 1 2 4`\ | |
| 471 | 471 | ` Maximal bytes/character 4 4 4` | |
| 472 | 472 | ||
| 473 | 473 | **UTF-8** tiene varias propiedades importantes y útiles: es interpretado como una secuencia de bytes, por lo que el concepto de orden bajo(lo-) y alto (hi-) no existe. Los caracteres U+0000 a U+007F (ASCII)se codifican simplemente como bytes 00h a 7Fh (por compatibilidad ASCII). Esto significa que los ficheros y cadenas que contienen solamente caracteres de 7-bit ASCII tienen la misma codificación en ambos formatos (ASCII y UTF-8). Todos los caracteres \>U+007F se codifican como una secuencia de varios bytes, cada uno de los cuales tiene los dos bits más significativos puestos a 1 (bits set). No se contiene una secuencia de bytes de un carácter dentro de la larga secuencia de bytes del otro. Esto permite la búsqueda sencilla de subcadenas. El primer byte de una secuencia multibyte que representa un carácter no-ASCII está siempre en el rango C0h a FDh y esto indica cuantos bytes siguen a este carácter. Todos los caracteres que que siguen en una secuencia multibyte se encuentran en el rango 80h a BFh. Esto permite una fácil resincronización y robustez. | |
| 474 | 474 | ||
| 475 | 475 | **UTF-16** tiene las siguientes propiedades más destacadas. Utiliza una sola palabra (words) de 16-bit para codificar caracteres desde U+0000 a U+d7ff, y un par de palabras de 16 bits para codificar cualquiera de los caracteres UNICODE restantes. remaining Unicode characters. | |
| 476 | 476 | ||
| 477 | 477 | Finalmente, cualquier caracter UNICODE puede ser representado como una unidad de 32 bits en **UTF-32**. | |
| 478 | 478 | ||
| 479 | 479 | Para más información, ver: | |
| 480 | 480 | ||
| 481 | 481 | [Unicode FAQ - Basic questions](http://www.unicode.org/faq/basic_q.html), [Unicode FAQ - UTF-8, UTF-16, UTF-32 & BOM](http://www.unicode.org/faq/utf_bom.html), [Wikipedia: UTF-8](http://en.wikipedia.org/wiki/UTF-8) [2](http://en.wikipedia.org/wiki/ISO-8859) | |
| 482 | 482 | ||
| 483 | 483 | ## Lo esencial de la arquitectura de la librería de componentes de Lazarus | |
| 484 | 484 | ||
| 485 | 485 | La LCL consta de dos partes: | |
| 486 | 486 | ||
| 487 | 487 | 1. Una parte independiente de la plataforma de destino, que implementa un jerarquía de clases análoga a la VCL de Delphi; | |
| 488 | 488 | 2. "Interfaces" - la parte que implementa la interfaz a las APIs de cada plataforma de destino. | |
| 489 | 489 | ||
| 490 | 490 | La comunicación entre las dos partes se realiza mediante una clase abstracta TWidgetset. Cada widgetset se implementa por su propia clase derivada de TWidgetset. | |
| 491 | 491 | ||
| 492 | 492 | El widgetset de GTK 1 es el más antiguo. En este widgetset se determina la codificación de los textos mediante la variable de entorno LANG, que suele ser un grupo iso ISO-8859-n de un solo byte de codificación. Recientemente (a partir de Mandriva 2007, por ejemplo), muchas distribuciones han distribuido Gtk 1 configurado para UTF-8. Nuestra interfaz Gtk 1 carece de un apoyo eficaz a UTF-8 en las rutinas de manejo del teclado, así que esto es un gran problema, que aumenta la necesidad de Lazarus de implementar soporte Unicode multiplataforma. | |
| 493 | 493 | ||
| 494 | 494 | El widgetset de Gtk2 únicamente funciona con codificación UTF-8 y suporta UTF-8 completamente. | |
| 495 | 495 | ||
| 496 | 496 | La interfaz win32 dispone de widgets ansi y el soporte UTF-8 se ha iniciado, pero no interface is setup with ansi widgets and UTF-8 support is started, pero no esta acabado y está deshabilitado. Por lo tanto, actualmente no es posible utilizar Unicode con win32. | |
| 497 | 497 | ||
| 498 | 498 | La interfaz Qt está preparada para UTF-8. El propio Qt usa UTF-16 como codificación nativa, pero la interfaz de Lazarus para Qt convierte de UTF-8 a UTF-16. | |
| 499 | 499 | ||
| 500 | 500 | Windows CE únicamente soporta UTF-16 pra la codificación de caracteres, pero nuestra interfaz para él ahora convierte las cadenas de ISO a UTF-16 antes de llamar a la API de Windows. Esto es muy fácil de solucionar, ya que todo el código de conversión se concentra en unas pocas rutinas en el archivo winceproc.pp. | |
| 501 | 501 | ||
| 502 | 502 | For more, see: [[LCL Internals|Internals of the LCL]] | |
| 503 | 503 | ||
| 504 | 504 | ## Habilitando UNICODE para el interface win32 | |
| 505 | 505 | ||
| 506 | 506 | ### Compilando LCL-Win32 con UNICODE | |
| 507 | 507 | ||
| 508 | 508 | Para habilitar UNICODE en LCL para Windows ir al menú, seleccionar entrada "Herramientas" --\> "Configurar "Construir Lazarus..." poner dWindowsUnicodeSupport en el campo "Opciones". Selecccionar todos los objetivos a NONE, y solo LCL a Clean+Build. Selecciona win32 como objetivo wdgetset. Finalmente pulsar en "Construir". | |
| 509 | 509 | ||
| 510 | 510 | Ahora ya puedes recompilar tus aplicaciones pre-existentes y tendrán el modo UNICODE habilitado. | |
| 511 | 511 | ||
| 512 | 512 | **Nota**: Desde la versión 0.9.25 revisión 14883 esta operación no es necesaria debido a que Lazarus tiene el soporte UNICODE habilitado por defecto. | |
| 513 | 513 | ||
| 514 | 514 | ### Directrices | |
| 515 | 515 | ||
| 516 | 516 | #### | |
| 517 | 517 | ||
| 518 | 518 | Primera, y más importante, todos los parches UNICODE para el interface Win32 deben ser incluidos por **{\$ifdef WindowsUnicodeSupport}**, para evitar romper el interface ANSI existente. Cuándo el código sea estable, todos los *ifdef* se quitaran y solamente permanecerá la parte UNICODE. En este momento todos los programas existentes que usan caracteres ANSI necesitaran migrar a UNICODE. | |
| 519 | 519 | ||
| 520 | 520 | Las plantaformas windows \<=Win9x se basan en códigos de página de la norma ISO y soportan Unicode de forma parcial. Las plataformas *win* a partir de WinNT y Windows CE suportan completamente UNICODE. Win 9x y NT ofrecen dos conjuntos paralelos de funciones API: el antiguo ANSI demoninado *A y el nuevo, UNICODE demonimado *W. Las funciones *W aceptan *wide strings*, por ejemplo cadenas codificadas UTF-16 como parámetros. Windows CE solamente utiliza funciones Wide API. | |
| 521 | 521 | ||
| 522 | 522 | #### Funciones Wide presentes en Windows 9x | |
| 523 | 523 | ||
| 524 | 524 | Algunas funciones Wide API están presentes en Windows 9x. La siguiente es una lista de las mismas: <http://msdn.microsoft.com/library/default.asp?url=/library/en-us/mslu/winprog/other_existing_unicode_support.asp> | |
| 525 | 525 | ||
| 526 | 526 | Ejemplo de conversión: | |
| 527 | 527 | ||
| 528 | 528 | ``` pascal | |
| 529 | 529 | GetTextExtentPoint32(hdcNewBitmap, LPSTR(ButtonCaption), | |
| 530 | 530 | Length(ButtonCaption), TextSize); | |
| 531 | 531 | ``` | |
| 532 | 532 | ||
| 533 | 533 | Viene a ser: | |
| 534 | 534 | ||
| 535 | 535 | ``` pascal | |
| 536 | 536 | {$ifdef WindowsUnicodeSupport} | |
| 537 | 537 | GetTextExtentPoint32W(hdcNewBitmap, PWideChar(Utf8Decode(ButtonCaption)), Length(WideCaption), TextSize); | |
| 538 | 538 | {$else} | |
| 539 | 539 | GetTextExtentPoint32(hdcNewBitmap, LPSTR(ButtonCaption), Length(ButtonCaption), TextSize); | |
| 540 | 540 | {$endif} | |
| 541 | 541 | ``` | |
| 542 | 542 | ||
| 543 | 543 | #### Funciones que necesitan versiones ANSI y Wide | |
| 544 | 544 | ||
| 545 | 545 | Primer ejemplo de conversión: | |
| 546 | 546 | ||
| 547 | 547 | ``` pascal | |
| 548 | 548 | function TGDIWindow.GetTitle: String; | |
| 549 | 549 | var | |
| 550 | 550 | l: Integer; | |
| 551 | 551 | begin | |
| 552 | 552 | l := Windows.GetWindowTextLength(Handle); | |
| 553 | 553 | SetLength(Result, l); | |
| 554 | 554 | Windows.GetWindowText(Handle, @Result[1], l); | |
| 555 | 555 | end; | |
| 556 | 556 | ``` | |
| 557 | 557 | ||
| 558 | 558 | Viene a ser así: | |
| 559 | 559 | ||
| 560 | 560 | ``` pascal | |
| 561 | 561 | function TGDIWindow.GetTitle: String; | |
| 562 | 562 | var | |
| 563 | 563 | l: Integer; | |
| 564 | 564 | AnsiBuffer: string; | |
| 565 | 565 | WideBuffer: WideString; | |
| 566 | 566 | begin | |
| 567 | 567 | ||
| 568 | 568 | {$ifdef WindowsUnicodeSupport} | |
| 569 | 569 | ||
| 570 | 570 | if UnicodeEnabledOS then | |
| 571 | 571 | begin | |
| 572 | 572 | l := Windows.GetWindowTextLengthW(Handle); | |
| 573 | 573 | SetLength(WideBuffer, l); | |
| 574 | 574 | l := Windows.GetWindowTextW(Handle, @WideBuffer[1], l); | |
| 575 | 575 | SetLength(WideBuffer, l); | |
| 576 | 576 | Result := Utf8Encode(WideBuffer); | |
| 577 | 577 | end | |
| 578 | 578 | else | |
| 579 | 579 | begin | |
| 580 | 580 | l := Windows.GetWindowTextLength(Handle); | |
| 581 | 581 | SetLength(AnsiBuffer, l); | |
| 582 | 582 | l := Windows.GetWindowText(Handle, @AnsiBuffer[1], l); | |
| 583 | 583 | SetLength(AnsiBuffer, l); | |
| 584 | 584 | Result := AnsiToUtf8(AnsiBuffer); | |
| 585 | 585 | end; | |
| 586 | 586 | ||
| 587 | 587 | {$else} | |
| 588 | 588 | ||
| 589 | 589 | l := Windows.GetWindowTextLength(Handle); | |
| 590 | 590 | SetLength(Result, l); | |
| 591 | 591 | Windows.GetWindowText(Handle, @Result[1], l); | |
| 592 | 592 | ||
| 593 | 593 | {$endif} | |
| 594 | 594 | ||
| 595 | 595 | end; | |
| 596 | 596 | ``` | |
| 597 | 597 | ||
| 598 | 598 | ### Recorrido | |
| 599 | 599 | ||
| 600 | 600 | #### Que debería estar ya funcionando con UNICODE: | |
| 601 | 601 | ||
| 602 | 602 | - TForm, TButton, TLabel. | |
| 603 | 603 | - La mayor parte de los controles. | |
| 604 | 604 | - Menús. | |
| 605 | 605 | - LCLIntf.ExtTextOut y muchas otras winapis de texto relacionadas. | |
| 606 | 606 | - Controles basados en TStrings. Ejemplos: TComboBox, TListBox, etc | |
| 607 | 607 | - SynEdit muestra y permite la introducción de caracteres UTF-8 correctamente. | |
| 608 | 608 | - Estableciendo(setting)/Obteniendo(Getting) cadenas UNICODE hacia/desde el portapapeles (ClipBoard). | |
| 609 | 609 | - Estableciendo el título de la aplicación en las opciones de proyecto a (por ejemplo) 'Mi aplicación'. | |
| 610 | 610 | - Haciendo doble ckick en palabras con caracteres no-ascii en el editor para seleccionarlos. | |
| 611 | 611 | ||
| 612 | 612 | #### Problemas conocidos con el soporte UNICODE | |
| 613 | 613 | ||
| 614 | 614 | - SynEdit no soporta RTL de derecha a izquierda (Right To Left) | |
| 615 | - | ||
| 615 | + | - ¿Ha sido OpenFileDialogCallBack testeado con un largo número de ficheros? | |
| 616 | 616 | - ¿Es esto un problema específico de UNICODE? Yo creo que es un problema genérico. --Sekelsenmat 13:40, 14 February 2008 (CET) | |
| 617 | 617 | - Puede ser. Lo he testeado con una gran cantidad de ficheros antes de añadir la versión UNICODE. Si se trata de un problema genérico, entonces la versión no-UNICODE estaría rota cuando la versión unicode fue añadida. Vincent 21:45, 15 February 2008 (CET) | |
| 618 | - | ||
| 619 | - | ||
| 620 | - | ||
| 618 | + | - Elemento asociado del seguidor de errores: <http://bugs.freepascal.org/view.php?id=10918> Corregido e implementado. | |
| 619 | + | - Función de clase TWin32WSSelectDirectoryDialog.CreateHandle: Title, nombre de fichero(FileName) y directorio inicial (InitialDir) debería ser convertido a UNICODE. | |
| 620 | + | - Associated bugtracker item: <http://bugs.freepascal.org/view.php?id=10919> Implementado. | |
| 621 | 621 | ||
| 622 | 622 | **Posibles problemas con el soporte UNICODE** | |
| 623 | 623 | ||
| 624 | 624 | Basandose en la revisión de código, lo siguiente necesita ser testeado porque el código parece no estar preparado para UNICODE: | |
| 625 | 625 | ||
| 626 | - | ||
| 626 | + | - Procedimiento de clase TWin32WSCustomComboBox.SetText | |
| 627 | 627 | - TWin32WSCustomTrayIcon.Show: ATrayIcon.Hint no soporta UNICODE | |
| 628 | - | ||
| 628 | + | - TWin32WidgetSet.MessageBox doesn't call MessageBoxW. | |
| 629 | 629 | - TWin32WidgetSet.TextOut: es Windows.TextOut soportado en windows 9X? | |
| 630 | 630 | - Si, por favor ver [[LCL Unicode Support/es|LCL_Unicode_Support/es#Wide_functions_present_on_Windows_9x]]. Althought I never tested this. | |
| 631 | 631 | - MessageBox buttons no muestran el UNICODE cuando son traducidos. Testeados en el IDE. Puede haber un problema en el IDE. | |
| 632 | 632 | - Nota: no he podido reproducirlo utilizando la traducción portuguesa. --Sekelsenmat 22:20, 12 January 2008 (CET) | |
| 633 | 633 | - (lista de problemas no confirmados, si se confirman pueden ser movidos al listado de arriba) | |
| 634 | 634 | ||
| 635 | 635 | ### Pantallazos | |
| 636 | 636 | ||
| 637 | 637 | 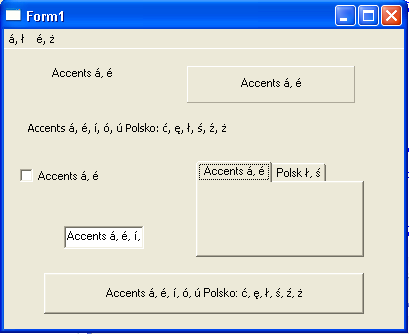 | |
| 638 | 638 | ||
| 639 | 639 | ## Ver también | |
| 640 | 640 | ||
| 641 | 641 | - [[UTF-8]] - Descripción de cadenas UTF-8. | |
| 642 | 642 | ||
| 643 | 643 | --- | |
| 644 | 644 | *From the Free Pascal wiki, page "LCL Unicode Support/es", as it stood on 2020-02-19 after a change by Trev, out of the wiki's dump of 2024-05-26. Copyright stays with the author who wrote it, according to the old wiki's [[Licensing]] page. If you have concerns about this material, [message the admin](/wiki-contact).* | |
| 645 | 645 | Category: Castellano | |
| 646 | 646 | Category: Español | |
| 647 | 647 | Category: LCL/es |