

LCL Unicode Support/de: what changed
Revision 2 to 3. Removed lines have a minus sign; added lines have a plus sign.
| Old | New | Line | |
|---|---|---|---|
| 1 | 1 | ## Einleitung | |
| 2 | 2 | ||
| 3 | 3 | Mit der Version 0.9.25 unterstützt Lazarus Unicode auf allen Plattformen außer auf Gtk 1. Diese Seite liefert Informationen für Anwender, die Strategie der Entwickler und eine Beschreibung der Konzepte und deren Anwendungsdetails. | |
| 4 | 4 | ||
| 5 | 5 | ## Anweisungen für Benutzer | |
| 6 | 6 | ||
| 7 | 7 | In Unicode-Interfaces - das anzumerken ist wichtig - ist nicht alles in Unicode. Die Free Pascal Laufzeitbibliothek (RTL) und die Free Pascal FCL-Bibliothek sind ANSI. Es liegt in der Verantwortung des Entwicklers zu wissen, welche Kodierung die Zeichenketten verwenden, und eine saubere Umwandlung durchzuführen zwischen Bibliotheken mit unterschiedlichen Kodierungen. | |
| 8 | 8 | ||
| 9 | 9 | Normalerweise erfolgt eine Kodierung pro Bibliothek (d. h. eine dynamische Bibliothek 'dll' oder ein Lazarus-Package). Jede Bibliothek erwartet 1 einheitliche Art von Kodierung, also üblicherweise entweder Unicode (UTF-8 für Lazarus) oder ANSI (das bedeutet die Systemkodierung, und kann utf-8 sein oder nicht). Die RTL und die FCL von FPC 2.4 erwarten ANSI-Zeichenketten. FPC 2.5.x derzeit auch. | |
| 10 | 10 | ||
| 11 | 11 | Sie können zwischen Unicode und ANSI konvertieren mittels der Funktionen **UTF8ToAnsi** und **AnsiToUTF8** aus der Unit 'System' oder mittels **UTF8ToSys** und **SysToUTF8** aus der Unit 'FileUtil'. Die beiden letzteren sind eleganter, stellen aber mehr Code in Ihr Programm. | |
| 12 | 12 | ||
| 13 | 13 | Beispiele: | |
| 14 | 14 | ||
| 15 | 15 | Angenommen Sie haben eine Zeichenkette aus einem TEdit und wollen diese an eine Routine aus der RTL übergeben: | |
| 16 | 16 | ||
| 17 | 17 | ``` pascal | |
| 18 | 18 | var | |
| 19 | 19 | MyString: string; // utf-8 encoded | |
| 20 | 20 | begin | |
| 21 | 21 | MyString := MyTEdit.Text; | |
| 22 | 22 | SomeRTLRoutine(UTF8ToAnsi(MyString)); | |
| 23 | 23 | end; | |
| 24 | 24 | ``` | |
| 25 | 25 | ||
| 26 | 26 | Und in der umgekehrten Richtung: | |
| 27 | 27 | ||
| 28 | 28 | ``` pascal | |
| 29 | 29 | var | |
| 30 | 30 | MyString: string; // ansi encoded | |
| 31 | 31 | begin | |
| 32 | 32 | MyString := SomeRTLRoutine; | |
| 33 | 33 | MyTEdit.Text := AnsiToUTF8(MyString); | |
| 34 | 34 | end; | |
| 35 | 35 | ``` | |
| 36 | 36 | ||
| 37 | 37 | **Wichtig**: UTF8ToAnsi gibt eine leere Zeichenkette zurück, wenn der UTF8-String ungültige Zeichen enthält. | |
| 38 | 38 | ||
| 39 | 39 | **Wichtig**: AnsiToUTF8 und UTF8ToAnsi brauchen einen Widestring-Manager unter Linux, BSD und Mac OS X. Sie können die Funktionen SysToUTF8 und UTF8ToSys (aus der Unit FileUtil) einsetzen oder einen Widestring-Manager, indem Sie 'cwstring' als eine der ersten Units zum uses-Abschnitt in Ihrem Programm hinzufügen. | |
| 40 | 40 | ||
| 41 | 41 | ### Der Umgang mit UTF8 Zeichenketten und Zeichen | |
| 42 | 42 | ||
| 43 | 43 | Wenn Sie die Zeichen einer UTF8-Zeichenkette durchlaufen wollen, gibt es dafür zwei unterschiedliche Arten: | |
| 44 | 44 | ||
| 45 | 45 | - durchlaufen Sie die Bytes - ist nützlich zum Suchen eines Teilstrings oder wenn Sie nur die ASCII-Zeichen eines UTF8-Strings betrachten wollen. Zum Beispiel beim Parsen einer xml-Datei. | |
| 46 | 46 | - durchlaufen Sie die Zeichen - ist nützlich für graphische Komponenten wie Synedit. Zum Beispiel wenn Sie wissen wollen, welches das dritte am Bildschirm dargestellte Zeichen ist. | |
| 47 | 47 | ||
| 48 | 48 | #### Suchen eines Teilstrings | |
| 49 | 49 | ||
| 50 | 50 | Wegen der besonderen Natur von UTF8 können Sie einfach die normalen Stringfunktionen verwenden: | |
| 51 | 51 | ||
| 52 | 52 | ``` pascal | |
| 53 | 53 | procedure Where(SearchFor, aText: string); | |
| 54 | 54 | var | |
| 55 | 55 | BytePos: LongInt; | |
| 56 | 56 | CharacterPos: LongInt; | |
| 57 | 57 | begin | |
| 58 | 58 | BytePos:=Pos(SearchFor,aText); | |
| 59 | 59 | CharacterPos:=UTF8Length(PChar(aText),BytePos-1); | |
| 60 | 60 | writeln('The substring "',SearchFor,'" is in the text "',aText,'"', | |
| 61 | 61 | ' at byte position ',BytePos,' and at character position ',CharacterPos); | |
| 62 | 62 | end; | |
| 63 | 63 | ``` | |
| 64 | 64 | ||
| 65 | 65 | #### Zugriff auf einen UTF8-String als Array | |
| 66 | 66 | ||
| 67 | 67 | Ein Array besteht aus aus Elementen gleicher Größe. Ein UTF8-Zeichen kann aber 1 bis 4 Bytes haben. Deshalb müssen Sie den UTF8-String konvertieren, entweder in ein Array aus Unicode-Werten (longwords) oder in ein Array aus PChar mit einem Zeiger auf jedes Zeichen. | |
| 68 | 68 | ||
| 69 | 69 | #### Durchlaufen von Zeichen mittels UTF8CharacterToUnicode | |
| 70 | 70 | ||
| 71 | 71 | Das Folgende demonstriert wie Sie die 32bit Unicode-Werte von Zeichen in einem UTF8-String durchlaufen: | |
| 72 | 72 | ||
| 73 | 73 | ``` pascal | |
| 74 | 74 | uses LCLProc; | |
| 75 | 75 | ... | |
| 76 | 76 | procedure IterateUTF8Characters(const AnUTF8String: string); | |
| 77 | 77 | var | |
| 78 | 78 | p: PChar; | |
| 79 | 79 | unicode: Cardinal; | |
| 80 | 80 | CharLen: integer; | |
| 81 | 81 | begin | |
| 82 | 82 | p:=PChar(AnUTF8String); | |
| 83 | 83 | repeat | |
| 84 | 84 | unicode:=UTF8CharacterToUnicode(p,CharLen); | |
| 85 | 85 | writeln('Unicode=',unicode); | |
| 86 | 86 | inc(p,CharLen); | |
| 87 | 87 | until (CharLen=0) or (unicode=0); | |
| 88 | 88 | end; | |
| 89 | 89 | ``` | |
| 90 | 90 | ||
| 91 | 91 | ### Der Umgang mit Verzeichnis- und Dateinamen | |
| 92 | 92 | ||
| 93 | 93 | Die Steuerelemente und Funktionen in Lazarus erwarten Dateinamen und Verzeichnisnamen in UTF-8 Kodierung, aber die RTL benutzt ANSI-Strings für Verzeichnisse und Dateinamen. | |
| 94 | 94 | ||
| 95 | 95 | Betrachten Sie beispielsweise eine Schaltfläche, die die Eigenschaft 'Directory' einer TFileListBox auf das aktuelle Verzeichnis setzt. Die RTL-Funktion [[doc:rtl/sysutils/getcurrentdir.html|GetCurrentDir]] ist ANSI, und nicht Unicode, deswegen muss man konvertieren: | |
| 96 | 96 | ||
| 97 | 97 | ``` pascal | |
| 98 | 98 | procedure TForm1.Button1Click(Sender: TObject); | |
| 99 | 99 | begin | |
| 100 | 100 | FileListBox1.Directory:=SysToUTF8(GetCurrentDir); | |
| 101 | 101 | // or use the functions from the FileUtil unit | |
| 102 | 102 | FileListBox1.Directory:=GetCurrentDirUTF8; | |
| 103 | 103 | end; | |
| 104 | 104 | ``` | |
| 105 | 105 | ||
| 106 | 106 | Die Unit 'FileUtil' definiert allgemeine Dateifunktionen mit UTF-8 Strings: | |
| 107 | 107 | ||
| 108 | 108 | ``` pascal | |
| 109 | 109 | // Basisfunktionen ähnlich zur RTL, aber arbeiten mit UTF-8 anstelle der | |
| 110 | 110 | // Systemkodierung | |
| 111 | 111 | ||
| 112 | 112 | // AnsiToUTF8 und UTF8ToAnsi brauchen einen Widestring-Manager unter Linux, BSD, Mac OS X, | |
| 113 | 113 | // aber normalerweise nehmen diese Betriebssysteme UTF-8 als Systemkodierung, dann ist | |
| 114 | 114 | // ein Widestring-Manager nicht nötig. | |
| 115 | 115 | function NeedRTLAnsi: boolean;// wahr, wenn die Systemkodierung nicht UTF-8 ist | |
| 116 | 116 | procedure SetNeedRTLAnsi(NewValue: boolean); | |
| 117 | 117 | function UTF8ToSys(const s: string): string;// wie UTF8ToAnsi, aber unabhängig von einem Widestring-Manager | |
| 118 | 118 | function SysToUTF8(const s: string): string;// wie AnsiToUTF8, aber unabhängig von einem Widestring-Manager | |
| 119 | 119 | ||
| 120 | 120 | // Dateioperationen | |
| 121 | 121 | function FileExistsUTF8(const Filename: string): boolean; | |
| 122 | 122 | function FileAgeUTF8(const FileName: string): Longint; | |
| 123 | 123 | function DirectoryExistsUTF8(const Directory: string): Boolean; | |
| 124 | 124 | function ExpandFileNameUTF8(const FileName: string): string; | |
| 125 | 125 | function ExpandUNCFileNameUTF8(const FileName: string): string; | |
| 126 | 126 | {$IFNDEF VER2_2_0} | |
| 127 | 127 | function ExtractShortPathNameUTF8(Const FileName : String) : String; | |
| 128 | 128 | {$ENDIF} | |
| 129 | 129 | function FindFirstUTF8(const Path: string; Attr: Longint; out Rslt: TSearchRec): Longint; | |
| 130 | 130 | function FindNextUTF8(var Rslt: TSearchRec): Longint; | |
| 131 | 131 | procedure FindCloseUTF8(var F: TSearchrec); | |
| 132 | 132 | function FileSetDateUTF8(const FileName: String; Age: Longint): Longint; | |
| 133 | 133 | function FileGetAttrUTF8(const FileName: String): Longint; | |
| 134 | 134 | function FileSetAttrUTF8(const Filename: String; Attr: longint): Longint; | |
| 135 | 135 | function DeleteFileUTF8(const FileName: String): Boolean; | |
| 136 | 136 | function RenameFileUTF8(const OldName, NewName: String): Boolean; | |
| 137 | 137 | function FileSearchUTF8(const Name, DirList : String): String; | |
| 138 | 138 | function FileIsReadOnlyUTF8(const FileName: String): Boolean; | |
| 139 | 139 | function GetCurrentDirUTF8: String; | |
| 140 | 140 | function SetCurrentDirUTF8(const NewDir: String): Boolean; | |
| 141 | 141 | function CreateDirUTF8(const NewDir: String): Boolean; | |
| 142 | 142 | function RemoveDirUTF8(const Dir: String): Boolean; | |
| 143 | 143 | function ForceDirectoriesUTF8(const Dir: string): Boolean; | |
| 144 | 144 | ||
| 145 | 145 | // Umgebung | |
| 146 | 146 | function ParamStrUTF8(Param: Integer): string; | |
| 147 | 147 | function GetEnvironmentStringUTF8(Index : Integer): String; | |
| 148 | 148 | function GetEnvironmentVariableUTF8(const EnvVar: String): String; | |
| 149 | 149 | function GetAppConfigDirUTF8(Global: Boolean): string; | |
| 150 | 150 | ``` | |
| 151 | 151 | ||
| 152 | 152 | #### Mac OS X | |
| 153 | 153 | ||
| 154 | 154 | Die Dateifunktionen der Unit 'FileUtil' berücksichtigen eine Besonderheit von Mac OS X: OS X normalisiert Dateiname. Zum Beispiel kann der Dateiname 'ä.txt' in Unicode mit zwei unterschiedlichen Sequenzen (#\$C3#\$A4 und 'a'#\$CC#\$88) kodiert werden. Unter Linux und BSD können Sie einen Dateinamen mit beiden Kodierungen erzeugen. OS X konvertiert automatisch den a-Umlaut in die drei Byte Sequenz. Das bedeutet: | |
| 155 | 155 | ||
| 156 | 156 | ``` pascal | |
| 157 | 157 | if Filename1=Filename2 then ... // reicht nicht aus unter OS X | |
| 158 | 158 | if AnsiCompareFileName(Filename1,Filename2)=0 then ... // reicht nicht aus unter fpc 2.2.2, nicht einmal mit 'cwstring' | |
| 159 | 159 | if CompareFilenames(Filename1,Filename2)=0 then ... // dies funktioniert immer (Unit FileUtil oder FileProcs) | |
| 160 | 160 | ``` | |
| 161 | 161 | ||
| 162 | 162 | ## UTF8 und Quelltextdateien - die fehlende BOM | |
| 163 | 163 | ||
| 164 | 164 | Wenn Sie mit Lazarus Quelltextdateien erzeugen und einige Nicht-ASCII-Zeichen eintippen, dann wird diese Datei mit UTF8 gespeichert. Es **verwendet keine BOM** (Byte-Ordnungs-Markierung). Sie können die Kodierung ändern mittels eines Rechtsklicks im Quelltexteditor / Dateieinstellungen / Zeichenkodierung. Der Grund für die fehlende BOM ist die Art, wie FPC ANSI-Strings behandelt. Für die Kompatibilität benutzt die LCL ANSI-Strings und für die Portabilität benutzt die LCL UTF8. | |
| 165 | 165 | ||
| 166 | 166 | Anmerkung: Einige MS Windows Texteditoren verarbeiten diese Dateien mit der System-Codepage und zeigen dann ungültige Zeichen an. Fügen Sie **keine** BOM hinzu. Wenn Sie eine BOM einfügen, müssen Sie alle Stringzuweisungen ändern. | |
| 167 | 167 | ||
| 168 | 168 | Zum Beispiel: | |
| 169 | 169 | ||
| 170 | 170 | ``` pascal | |
| 171 | 171 | Button1.Caption := 'Über'; | |
| 172 | 172 | ``` | |
| 173 | 173 | ||
| 174 | 174 | Wenn keine BOM vorliegt (und kein Codepage-Parameter übergeben wurde), dann behandelt der Compiler die Zeichenkette wie systemkodiert und kopiert jedes Byte unkonvertiert in die Zeichenkette. Genau so erwartet die LCL die Zeichenketten. | |
| 175 | 175 | ||
| 176 | 176 | ``` pascal | |
| 177 | 177 | // Quelltextdatei gespeichert als UTF ohne BOM | |
| 178 | 178 | if FileExists('Über.txt') then ; // falsch, weil 'FileExists' Systemkodierung erwartet | |
| 179 | 179 | if FileExistsUTF8('Über.txt') then ; // richtig | |
| 180 | 180 | ``` | |
| 181 | 181 | ||
| 182 | 182 | ## Widestrings und Ansistrings | |
| 183 | 183 | ||
| 184 | 184 | Wenn Sie Ansistrings an Widestrings übergeben, müssen Sie die Kodierung konvertieren. | |
| 185 | 185 | ||
| 186 | 186 | ``` pascal | |
| 187 | 187 | var | |
| 188 | 188 | w: widestring; | |
| 189 | 189 | begin | |
| 190 | 190 | w:='Über'; // falsch, weil der FPC die System-Codepage zu UTF16 konvertiert | |
| 191 | 191 | w:=UTF8ToUTF16('Über'); // richtig | |
| 192 | 192 | Button1.Caption:=UTF16ToUTF8(w); | |
| 193 | 193 | end; | |
| 194 | 194 | ``` | |
| 195 | 195 | ||
| 196 | 196 | ## Quelltextdatei mit UTF8 BOM | |
| 197 | 197 | ||
| 198 | 198 | Wenn Sie in einer Unit zahlreiche Konvertierungen von Widestrings durchführen, könnte der Code dadurch lesbarer werden, dass Sie den Quelltext als UTF8 mit BOM abspeichern. Der Compiler erlaubt pro Unit eine Kodierung. | |
| 199 | 199 | ||
| 200 | 200 | ### Ostasiatische Sprachen unter Windows | |
| 201 | 201 | ||
| 202 | 202 | Die Vorgabeschriftart (Tahoma) für Benutzerinterface-Steuerelemente unter Windows XP kann verschiedene Sprachen korrekt anzeigen, darunter Arabisch, Russisch und westliche Sprachen, aber nicht ostasiatische Sprachen, wie Chinesisch, Japanisch oder Koreanisch. Gehen Sie zur Systemsteuerung, wählen Sie 'Region und Sprache' aus, klicken Sie auf die Sprachformate und installieren Sie das East Asia Language Pack. Dadurch wird die Vorgabeschriftart ab jetzt diese Sprachen korrekt anzeigen. Natürlich haben Windows XP Versionen, die für diese Sprachen lokalisiert wurden, dieses Sprachpaket bereits installiert. Genauere Instruktionen gibt es [hier](http://newton.uor.edu/Departments&Programs/AsianStudiesDept/Language/asianlanguageinstallation_XP.html). | |
| 203 | 203 | ||
| 204 | 204 | ## Implementierungsrichtlinien | |
| 205 | 205 | ||
| 206 | 206 | ### Voraussetzungen | |
| 207 | 207 | ||
| 208 | 208 | Die Vision von Lazarus ist: "Write once, compile everywhere." Das bedeutet im Idealfall, eine Applikation, die Unicode eingeschaltet hat, hat nur einen Source-Code, der für alle Plattformen gültig ist, ohne irgendwelche konditionalen Definitionen. | |
| 209 | 209 | ||
| 210 | 210 | Der "Interface" Teil der LCL sollte Unicode für die Zielplattform bereitstellen, die Zielplattform sollte Unicode selber unterstützen, ohne den Anwendungsprogrammierer mit Details zu belästigen. | |
| 211 | 211 | ||
| 212 | 212 | Was Lazarus betrifft, ist die interne String-Kommunikation an den Schnittstellen "Anwendungscode \<--\> LCL" und "LCL \<--\> Widgetsets". Beide basieren nämlich auf den klassischen byte-orientierten Strings. Logisch sollten diese String konvertiert werden zu dem Code [[UTF-8]]. | |
| 213 | 213 | ||
| 214 | 214 | ### Migration zu Unicode | |
| 215 | 215 | ||
| 216 | 216 | Die meisten existierenden Versionen von Lazarus benutzen die ANSI-Kodierung, weil dies der Standard war für die Gtk1 und win32 Interfaces bis zur Version 0.9.24. Ab 0.9.25 verwenden alle Interfaces [[UTF-8]] als Standard (mit Ausnahme von gtk1, das [[UTF-8]] nur dann unterstützt, wenn auch die Systemkodierung [[UTF-8]] ist, und selbst damit gibt es Einschränkungen). Deshalb müssen alle Anwendungen, die Zeichenketten direkt an das Interface übergeben (sei es geschrieben im Code oder im Objektinspektor) diese Zeichenketten zu UTF-8 konvertieren. | |
| 217 | 217 | ||
| 218 | 218 | Derzeit haben wir verschiedene Gruppen von Interfaces, je nach Kodierung: | |
| 219 | 219 | ||
| 220 | 220 | - Interfaces die die ANSI-Kodierung verwenden: gtk (1) auf ANSI Systemen. | |
| 221 | 221 | ||
| 222 | 222 | - Interfaces die die [[UTF-8]]-Kodierung verwenden: gtk (1) auf UTF-8 Systemen, gtk2, qt, [[fpGUI]], carbon, win32, wince, alle anderen | |
| 223 | 223 | ||
| 224 | 224 | Beachten Sie, dass gtk (1) sowohl in den Gruppen ANSI als auch UTF-8 aufscheint. Das ist, weil die Kodierung von einer Umgebungsvariablen unter Gtk 1 kontrolliert wird. | |
| 225 | 225 | ||
| 226 | 226 | Die IDE wurde erweitert für das Laden/Speichern/Bearbeiten von Dateien mit unterschiedlichen Kodierungen (1 Kodierung pro Datei). Sie hat eine eingebaute Heuristik um die Kodierung zu ermitteln und Sie können die Kodierung einer Datei zu jedem Zeitpunkt ändern (Quelltexteditor / Popup-Menü / Dateieinstellungen / Kodierung). So kann die IDE alte Dateien und Projekte öffnen und auch zum Konvertieren der Kodierung benutzt werden. | |
| 227 | 227 | ||
| 228 | 228 | ## Roadmap | |
| 229 | 229 | ||
| 230 | 230 | Da wir nunmehr Richtlinien haben, ist es an der Zeit eine "Roadmap" auszuarbeiten und diese Realität werden zu lassen. Vor diesem Hintergrund wurde der nachfolgend dargestellte Plan aufgestellt. Dieser Plan teilt die Aufgaben in zwei Gruppen ein. Eine Gruppe für primäre, eine für sekundäre Aufgaben. | |
| 231 | 231 | ||
| 232 | 232 | Alle primären Aufgaben müssen vollständig umgesetzt sein, bevor wir davon sprechen können, dass Lazarus Unicode-fähig ist. Diesen primären Aufgaben gilt daher unser Hauptaugenmerk. An ihnen werden wir bevorzugt arbeiten. | |
| 233 | 233 | ||
| 234 | 234 | Sekundäre Aufgaben sind zwar wünschenswert, werden aber erst umgesetzt, wenn sich für die Aufgabe jemand findet, der sie umsetzt. | |
| 235 | 235 | ||
| 236 | 236 | ### Primäre Aufgaben | |
| 237 | 237 | ||
| 238 | 238 | **Ziel: Win32 Widgetset unterstützt UTF-8** | |
| 239 | 239 | ||
| 240 | 240 | Anmerkungen: On this step we will target all 32-bits Windows versions at the same time. All code produced on this effort will be isolated from the current win32 interface by IFDEFs, to avoid introducing bugs on this primary interface. After the transition time, the IFDEFs will be removed and only the Unicode code will remain. | |
| 241 | 241 | ||
| 242 | 242 | Status: vollständig implementiert | |
| 243 | 243 | ||
| 244 | 244 | **Aktualisieren der GTK2 Tastaturfunktionen, damit sie mit UTF-8 funktionieren** | |
| 245 | 245 | ||
| 246 | 246 | Anmerkungen: | |
| 247 | 247 | ||
| 248 | 248 | Status: fast vollendet. Some pre-editing features of the gtk2 are not yet supported in custom controls. I don't know, which language needs them. | |
| 249 | 249 | ||
| 250 | 250 | **Make sure the Lazarus IDE runs correctly with Win32 Unicode widgetset and supports UTF-8** | |
| 251 | 251 | ||
| 252 | 252 | Anmerkungen: | |
| 253 | 253 | ||
| 254 | 254 | Status: vollendet. Mit Ausnahme der Zeichentabelle ("Character-Map"), sie zeigt weiterhin lediglich 255 Zeichen. Aber alle modernen Betriebssysteme bieten ohnehin schöne Unicode-Zeichentabellen. | |
| 255 | 255 | ||
| 256 | 256 | **Make sure the Lazarus IDE runs correctly with Gtk 2 widgetset and supports UTF-8** | |
| 257 | 257 | ||
| 258 | 258 | Anmerkungen: | |
| 259 | 259 | ||
| 260 | 260 | Status: vollendet. Es gibt noch GTK2 intf bugs, aber diese haben nichts mit UTF-8 zu tun. | |
| 261 | 261 | ||
| 262 | 262 | ### Sekundäre Aufgaben | |
| 263 | 263 | ||
| 264 | 264 | **Aktualisieren des Windows CE Interfaces, damit es UTF-8 benutzt** | |
| 265 | 265 | ||
| 266 | 266 | Anmerkungen: String-Umwandlungsroutinen konzentrieren sich auf die winceproc.pp file. Hier sind noch viele Tests notwendig. | |
| 267 | 267 | ||
| 268 | 268 | Status: vollendet | |
| 269 | 269 | ||
| 270 | 270 | **Aktualisieren der GTK1 Tastaturfunktionen, damit sie mit UTF-8 funktionieren** | |
| 271 | 271 | ||
| 272 | 272 | Anmerkungen: | |
| 273 | 273 | ||
| 274 | 274 | Status: nicht implementiert. | |
| 275 | 275 | ||
| 276 | 276 | **RTL in synedit vervollständigen** | |
| 277 | 277 | ||
| 278 | 278 | Anmerkungen: RTL meint von rechts nach links (right to left) wie es z.B. im Arabischen verwendet wird | |
| 279 | 279 | ||
| 280 | 280 | Status: nicht implementiert. | |
| 281 | 281 | ||
| 282 | 282 | ## Grundlagen von Unicode | |
| 283 | 283 | ||
| 284 | 284 | Der Unicode-Standard weist den Integerzahlen von 0 bis 10FFFF(h) Zeichen zu. Jede solche Zuweisung wird auch "Codepoint" genannt. Mit anderen Worten, die Unicode-Zeichen sind im Prinzip definiert für die Codepoints von U+000000 bis U+10FFFF (0 to 1 114 111). | |
| 285 | 285 | ||
| 286 | 286 | Es gibt drei Schemata, um Unicode-Codepoints als eindeutige Bytesequenzen abzubilden. Diese Schemata nennt man Unicode-Transformationsformate: UTF-8, UTF-16 und UTF-32. Die Umwandlung untereinander ist möglich. Hier sind ihre grundlegenden Eigenschaften: | |
| 287 | 287 | ||
| 288 | - | ||
| 289 | - | ||
| 290 | - | ||
| 291 | - | ||
| 292 | - | ||
| 293 | - | ||
| 288 | + | ```text | |
| 289 | + | UTF-8 UTF-16 UTF-32 | |
| 290 | + | Kleinster Codepoint [hex] 000000 000000 000000 | |
| 291 | + | Größter Codepoint [hex] 10FFFF 10FFFF 10FFFF | |
| 292 | + | Größe der Codeeinheit [Bits] 8 16 32 | |
| 293 | + | Minimale Bytes/Zeichen 1 2 4 | |
| 294 | + | Maximale Bytes/Zeichen 4 4 4 | |
| 295 | + | ``` | |
| 294 | 296 | ||
| 295 | 297 | **UTF-8** hat einige wichtige und nützliche Eigenschaften: Es wird interpretiert als Sequenz von Bytes, darum existiert das Konzept von nieder- und hochwertigem (lo- and hi-order) Byte nicht. Die Unicode- Zeichen U+0000 bis U+007F (ASCII) sind einfach als Bytes 00h bis 7Fh kodiert (ASCII Kompatibilität). Dies bedeutet, dass Dateien und Zeichenketten die nur 7-Bit ASCII-Zeichen enthalten die gleiche Kodierung sowohl unter ASCII als auch unter UTF-8 haben. Alle Zeichen \> U+007F sind kodiert als Sequenz mehrerer Bytes, deren zwei höchste Bits gesetzt sind. Nie ist eine Bytesequenz eines Zeichens in einer längeren Bytesequenz eines anderen Zeichens enthalten. Dies erlaubt eine Suche nach Teilstrings. Das erste Byte einer Multibyte-Sequenz, die ein nicht-ASCII-Zeichen darstellt ist immer im Bereic C0h bis FDh und es zeigt, wie viele Bytes für dieses Zeichen noch folgen. Alle weiteren Bytes in einer Multibyte-Sequenz sind im Bereich 80h bis BFh. Dadurch werden leichte Resynchronisation und Robustheit möglich. | |
| 296 | 298 | ||
| 297 | 299 | **UTF-16** hat die folgenden wichtigen Eigenschaften: Es benutzt ein einzelnes 16-Bit Wort zum Kodieren der Zeichen von U+0000 bis U+d7ff, und ein Paar von 16-Bit Worten, um jedes der restlichen Unicode-Zeichen zu kodieren. | |
| 298 | 300 | ||
| 299 | 301 | Zuletzt kann jedes Unicode-Zeichen auch als einzelne 32-Bit Einheit in **UTF-32** dargestellt werden. | |
| 300 | 302 | ||
| 301 | 303 | Für weitere Informationen siehe: [Unicode FAQ - Basic questions](http://www.unicode.org/faq/basic_q.html), [Unicode FAQ - UTF-8, UTF-16, UTF-32 & BOM](http://www.unicode.org/faq/utf_bom.html), [Wikipedia: UTF-8](http://en.wikipedia.org/wiki/UTF-8) [1](http://en.wikipedia.org/wiki/ISO-8859) | |
| 302 | 304 | ||
| 303 | 305 | ## Grundlagen der Lazarus-Komponentenbibliotheks-Architektur | |
| 304 | 306 | ||
| 305 | 307 | Die LCL besteht aus zwei Teilen: | |
| 306 | 308 | ||
| 307 | 309 | 1. Einem von der Zielplattform unabhängigen Teil, der eine Klassenhierarchie analog zur Delphi VCL implementiert; | |
| 308 | 310 | 2. "Interfaces" - einem Teil der das Interface zu den APIs einer jeden Zielplattform implementiert. | |
| 309 | 311 | ||
| 310 | 312 | Die Kommunikation zwischen den beiden Teilen erfolgt durch eine abstrakte Klasse 'TWidgetset'. Jedes Interface ist implementiert durch seine eigene, von TWidgetset abgeleitete Klasse. | |
| 311 | 313 | ||
| 312 | 314 | Das GTK 1 Interface ist das älteste. In diesem Widgetset ist die Zeichenkettenkodierung bestimmt durch die Umgebungsvariable 'LANG' (???--- , which is usually a iso The ISO-8859-n group of single byte encodings---???). Zuletzt (zum Beispiel bei Mandriva 2007), haben viele Distributionen ein Gtk 1 ausgeliefert, das für UTF-8 konfiguriert war. Unserem Gtk 1 Interface fehlt die vollständige Unterstützung für UTF-8 in den Tastaturverarbeitungsroutinen. Dieses große Problem zeigt, wie wichtig es für Lazarus ist, eine plattformübergreifende Unicodeunterstützung zu implementieren. | |
| 313 | 315 | ||
| 314 | 316 | Das Gtk2 Interface arbeitet nur mit UTF-8 Kodierung und unterstützt UTF-8 vollständig. | |
| 315 | 317 | ||
| 316 | 318 | Ab Lazarus 0.9.28 unterstützen das Windows und Windows CE Interface Unicode vollständig. | |
| 317 | 319 | ||
| 318 | 320 | Das Qt Interface ist für UTF-8 vorbereitet. Qt selbst benutzt UTF-16 als eingebaute Kodierung, aber das Lazarus Interface für Qt konvertiert von UTF-8 zu UTF-16. | |
| 319 | 321 | ||
| 320 | 322 | Für weitere Informationen siehe: [[LCL Internals|Internals of the LCL]] | |
| 321 | 323 | ||
| 322 | 324 | ## Vorbereitung des Win32-Interfaces für Unicode | |
| 323 | 325 | ||
| 324 | 326 | ### Richtlinien | |
| 325 | 327 | ||
| 326 | 328 | Als erstes, und auch wichtigstes, müssen alle Unicode-Patches für das Win32-Interface in Anweisungen für bedingte Kompilierung (IFDEF WindowsUnicodeSupport) eingeschlossen sein, um zu verhindern, dass das existierende ANSI-Interface zerbricht. Nachdem sich dies stabilisiert hat, werden alle IFDEFs entfernt und nur der Unicodeteil bleibt bestehen. Zu diesem Zeitpunkt brauchen alle Programme die ANSI-Zeichen verwenden eine Migration hin zu Unicode. | |
| 327 | 329 | ||
| 328 | 330 | Windows-Plattformen \<= Win9x basieren auf den Standards der ISO Codeseiten und unterstützen Unicode nur teilweise. Die Windows-Plattformen beginnend mit WinNT und Windows CE unterstützen Unicode vollständig. Win 9x und NT bieten deshalb zwei parallele Mengen von API-Funktionen: die alten ANSI-fähigen *A und die neuen Unicode-fähigen *W. *W Funktionen akzeptieren Widestrings, d.h. UTF-16 kodierte Strings, als Parameter. Windows CE verwendet nur die Wide API Funktionen. | |
| 329 | 331 | ||
| 330 | 332 | #### Wide-Funktionen, die es unter Windows 9x gibt | |
| 331 | 333 | ||
| 332 | 334 | Einzelne Wide API Funktionen gibt es unter Windows 9x. Hier ist eine Liste solcher Funktionen: <http://msdn.microsoft.com/library/default.asp?url=/library/en-us/mslu/winprog/other_existing_unicode_support.asp> | |
| 333 | 335 | ||
| 334 | 336 | Konvertierungsbeispiel: | |
| 335 | 337 | ||
| 336 | 338 | GetTextExtentPoint32(hdcNewBitmap, LPSTR(ButtonCaption), | |
| 337 | 339 | Length(ButtonCaption), TextSize); | |
| 338 | 340 | ||
| 339 | 341 | wird zu: | |
| 340 | 342 | ||
| 341 | 343 | ``` pascal | |
| 342 | 344 | {$ifdef WindowsUnicodeSupport} | |
| 343 | 345 | GetTextExtentPoint32W(hdcNewBitmap, PWideChar(Utf8Decode(ButtonCaption)), Length(WideCaption), TextSize); | |
| 344 | 346 | {$else} | |
| 345 | 347 | GetTextExtentPoint32(hdcNewBitmap, LPSTR(ButtonCaption), Length(ButtonCaption), TextSize); | |
| 346 | 348 | {$endif} | |
| 347 | 349 | ``` | |
| 348 | 350 | ||
| 349 | 351 | #### Funktionen die ANSI- und Wide- Versionen benötigen | |
| 350 | 352 | ||
| 351 | 353 | Erstes Konvertierungsbeispiel: | |
| 352 | 354 | ||
| 353 | 355 | ``` pascal | |
| 354 | 356 | function TGDIWindow.GetTitle: String; | |
| 355 | 357 | var | |
| 356 | 358 | l: Integer; | |
| 357 | 359 | begin | |
| 358 | 360 | l := Windows.GetWindowTextLength(Handle); | |
| 359 | 361 | SetLength(Result, l); | |
| 360 | 362 | Windows.GetWindowText(Handle, @Result[1], l); | |
| 361 | 363 | end; | |
| 362 | 364 | ``` | |
| 363 | 365 | ||
| 364 | 366 | wird zu: | |
| 365 | 367 | ||
| 366 | 368 | ``` pascal | |
| 367 | 369 | function TGDIWindow.GetTitle: String; | |
| 368 | 370 | var | |
| 369 | 371 | l: Integer; | |
| 370 | 372 | AnsiBuffer: string; | |
| 371 | 373 | WideBuffer: WideString; | |
| 372 | 374 | begin | |
| 373 | 375 | ||
| 374 | 376 | {$ifdef WindowsUnicodeSupport} | |
| 375 | 377 | ||
| 376 | 378 | if UnicodeEnabledOS then | |
| 377 | 379 | begin | |
| 378 | 380 | l := Windows.GetWindowTextLengthW(Handle); | |
| 379 | 381 | SetLength(WideBuffer, l); | |
| 380 | 382 | l := Windows.GetWindowTextW(Handle, @WideBuffer[1], l); | |
| 381 | 383 | SetLength(WideBuffer, l); | |
| 382 | 384 | Result := Utf8Encode(WideBuffer); | |
| 383 | 385 | end | |
| 384 | 386 | else | |
| 385 | 387 | begin | |
| 386 | 388 | l := Windows.GetWindowTextLength(Handle); | |
| 387 | 389 | SetLength(AnsiBuffer, l); | |
| 388 | 390 | l := Windows.GetWindowText(Handle, @AnsiBuffer[1], l); | |
| 389 | 391 | SetLength(AnsiBuffer, l); | |
| 390 | 392 | Result := AnsiToUtf8(AnsiBuffer); | |
| 391 | 393 | end; | |
| 392 | 394 | ||
| 393 | 395 | {$else} | |
| 394 | 396 | ||
| 395 | 397 | l := Windows.GetWindowTextLength(Handle); | |
| 396 | 398 | SetLength(Result, l); | |
| 397 | 399 | Windows.GetWindowText(Handle, @Result[1], l); | |
| 398 | 400 | ||
| 399 | 401 | {$endif} | |
| 400 | 402 | ||
| 401 | 403 | end; | |
| 402 | 404 | ``` | |
| 403 | 405 | ||
| 404 | 406 | ### Roadmap | |
| 405 | 407 | ||
| 406 | 408 | #### Was bereits mit Unicode funktionieren sollte: | |
| 407 | 409 | ||
| 408 | 410 | - TForm, TButton, TLabel | |
| 409 | 411 | - die meisten Controls | |
| 410 | 412 | - Menüs | |
| 411 | 413 | - LCLIntf.ExtTextOut und die meisten anderen textbezogenen WinAPIs | |
| 412 | 414 | - TStrings-basierte Steuerelemente. Beispiele: TComboBox, TListBox, etc... | |
| 413 | 415 | - SynEdit kann UTF-8 Zeichen korrekt anzeigen und als Eingabe entgegennehmen | |
| 414 | 416 | - Unicode-Zeichenketten zur/von der Zwischenablage schicken/empfangen | |
| 415 | 417 | - Den Anwendungstitel in den Projekteinstellungen setzen. Zum Beispiel auf: 'Minha Aplicação'. | |
| 416 | 418 | - Doppelklick im Editor auf Wörter mit nicht-ASCII Zeichen wählt diese Wörter aus | |
| 417 | 419 | ||
| 418 | 420 | #### Bekannte Probleme bei der Unicode-Unterstützung: | |
| 419 | 421 | ||
| 420 | 422 | - Viele Komponenten unterstützen RTL nicht oder nur fehlerhaft | |
| 421 | 423 | - SynEdit unterstützt nicht RTL (right to left, von rechts nach links) | |
| 422 | 424 | - Is OpenFileDialogCallBack tested with selection large numbers of files? | |
| 423 | 425 | - Is this problem unicode specific? I think it's a generic problem. --Sekelsenmat 13:40, 14 February 2008 (CET) | |
| 424 | 426 | - Maybe. I know I tested it with large number of files before the Unicode version was added. If it is a generic problem, then the the non-Unicode version got broken, when the Unicode version was added. Vincent 21:45, 15 February 2008 (CET) | |
| 425 | 427 | - Associated bugtracker item: <http://bugs.freepascal.org/view.php?id=10918> Fixed and implemented. | |
| 426 | 428 | - class function TWin32WSSelectDirectoryDialog.CreateHandle: Title, FileName and InitialDir should be made Unicode aware. | |
| 427 | 429 | - Associated bugtracker item: <http://bugs.freepascal.org/view.php?id=10919> Implemented. | |
| 428 | 430 | ||
| 429 | 431 | **Mögliche Probleme bei der Unicode-Unterstützung** | |
| 430 | 432 | ||
| 431 | 433 | Basierend auf einer Durchsicht des Codes, sollten folgende Punkte getestet werden, weil der dortige Code nicht Unicode-fähig zu sein scheint: | |
| 432 | 434 | ||
| 433 | 435 | - class procedure TWin32WSCustomComboBox.SetText | |
| 434 | 436 | - TWin32WSCustomTrayIcon.Show: ATrayIcon.Hint is not Unicode aware | |
| 435 | 437 | - TWin32WidgetSet.MessageBox doesn't call MessageBoxW. | |
| 436 | 438 | - TWin32WidgetSet.TextOut: Is Windows.TextOut supported on windows 9X? | |
| 437 | 439 | - Yes, please see [[LCL Unicode Support|LCL_Unicode_Support#Wide_functions_present_on_Windows_9x]]. Althought I never tested this. | |
| 438 | 440 | - MessageBox buttons don't show unicode correctly when they are translated. Tested on the IDE. Could be a problem on the IDE however. | |
| 439 | 441 | - Note: I couldn't reproduce using the portuguese translation --Sekelsenmat 22:20, 12 January 2008 (CET) | |
| 440 | 442 | - (list of unconfirmed problems, if confirmed can be moved to the list above) | |
| 441 | 443 | ||
| 442 | 444 | ### Screenshots | |
| 443 | 445 | ||
| 444 | 446 | 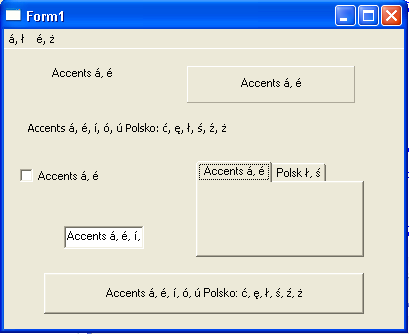 | |
| 445 | 447 | ||
| 446 | 448 | ## Siehe auch | |
| 447 | 449 | ||
| 448 | 450 | - [[UTF-8]] - Beschreibung von UTF-8 Zeichenketten | |
| 449 | 451 | ||
| 450 | 452 | --- | |
| 451 | 453 | *From the Free Pascal wiki, page "LCL Unicode Support/de", as it stood on 2020-02-19 after a change by Trev, out of the wiki's dump of 2024-05-26. Copyright stays with the author who wrote it, according to the old wiki's [[Licensing]] page. If you have concerns about this material, [message the admin](/wiki-contact).* |